RunPod Serverless do rozpoznawania obrazów: zimne starty, realne koszty i alternatywy
RunPod Serverless nalicza opłatę za workera od sekundy, w której startuje, aż do pełnego zatrzymania, razem z czasem bezczynności. Ta jedna zasada przekreśla popularny trik z pingiem keep-alive i decyduje o tym, jak serwować embeddingi CLIP do rozpoznawania obrazów. Pokazujemy rachunek prostym językiem, konfigurację, którą mamy na produkcji w Museo, i ile kosztują alternatywy w przeliczeniu na 1000 zdjęć.
 Autor: Eryk Kruk, CEO
Chcesz, żeby aplikacja rozpoznawała zdjęcie w chwili, gdy użytkownik je robi, i nie chcesz płacić za kartę graficzną, która całą noc stoi bezczynnie. Ten tekst rozwiązuje ten problem dla rozpoznawania obrazów modelem CLIP na RunPod Serverless. Dostajesz jedną zasadę rozliczeń, która decyduje o kosztach, konfigurację, którą mamy na produkcji w Museo, i ceny alternatyw w przeliczeniu na 1000 zdjęć (stan na listopad 2026).
Krótka odpowiedź: RunPod Serverless dobrze sprawdza się przy embeddingach CLIP, gdy ruch przychodzi sesjami z przerwami. Ustaw min workers na 0, zostaw limit bezczynności na 5 sekundach, włącz FlashBoot i rozgrzewaj workera tylko wtedy, gdy ktoś naprawdę korzysta z aplikacji. Nie pinguj workerów, żeby były ciepłe: RunPod liczy czas oczekiwania, więc pingowany worker jest rozliczany 24/7. Dla miejsca otwartego 8 godzin dziennie to około 180 USD miesięcznie zamiast 547,50 USD za jednego workera rozgrzanego całą dobę.
Natychmiastowe rozpoznawanie obrazów bez płacenia za bezczynne GPU: na czym polega problem?
W skrócie: GPU, które czeka na kolejne zdjęcie, kosztuje tyle samo co GPU, które pracuje. Rozpoznawanie obrazu w czasie rzeczywistym wymaga rozgrzanego modelu w chwili, gdy użytkownik celuje aparatem, a ruch w większości aplikacji przychodzi falami: zwiedzający skanuje dziesięć obiektów w dwadzieścia minut, a potem przez godzinę nic. Cały problem to być natychmiast przy pierwszym skanie i nie płacić za tę godzinę przerwy.
Dalej używamy pięciu pojęć. Oto one, prostymi słowami:
- GPU: procesor graficzny, który szybko uruchamia modele AI. W chmurze wynajmujesz go na sekundy.
- CLIP: otwarty model AI, który patrzy na obraz i zamienia go na listę liczb opisującą, co na nim jest.
- Embedding (wektor): właśnie ta lista liczb. Wyobraź sobie adres na mapie wyglądu rzeczy. Dwa zdjęcia tego samego obrazu dostają adresy blisko siebie, więc znalezienie dopasowania to znalezienie najbliższego adresu.
- Serverless: nie wynajmujesz maszyny na cały miesiąc. Platforma uruchamia kopię twojego modelu, czyli workera, gdy przychodzą zapytania, i wyłącza ją, gdy się kończą.
- Zimny start (cold start): czas, w którym zatrzymany worker startuje i ładuje model. Zwiedzający, który stoi przed obrazem, czuje każdą sekundę.
Museo: prawdziwy projekt, z którego pochodzi każda liczba w tym tekście
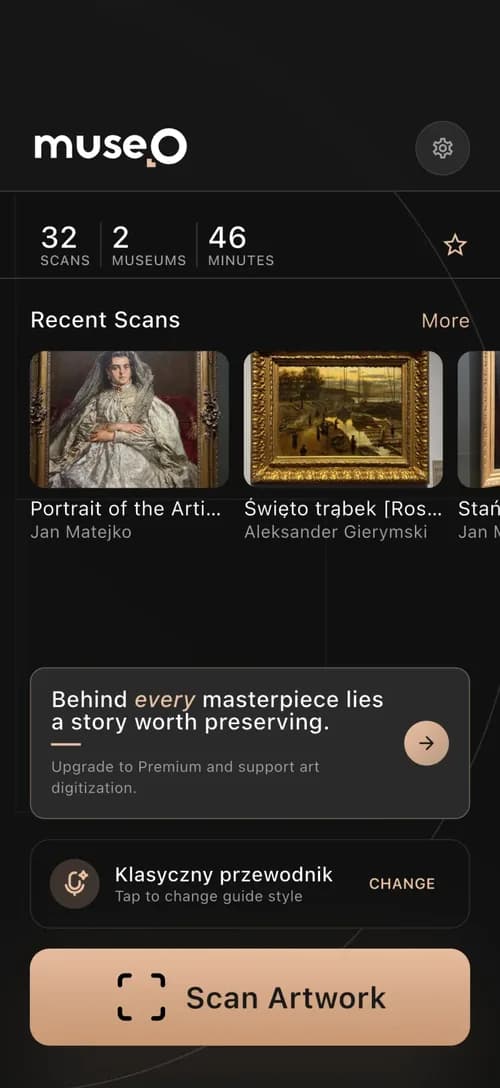
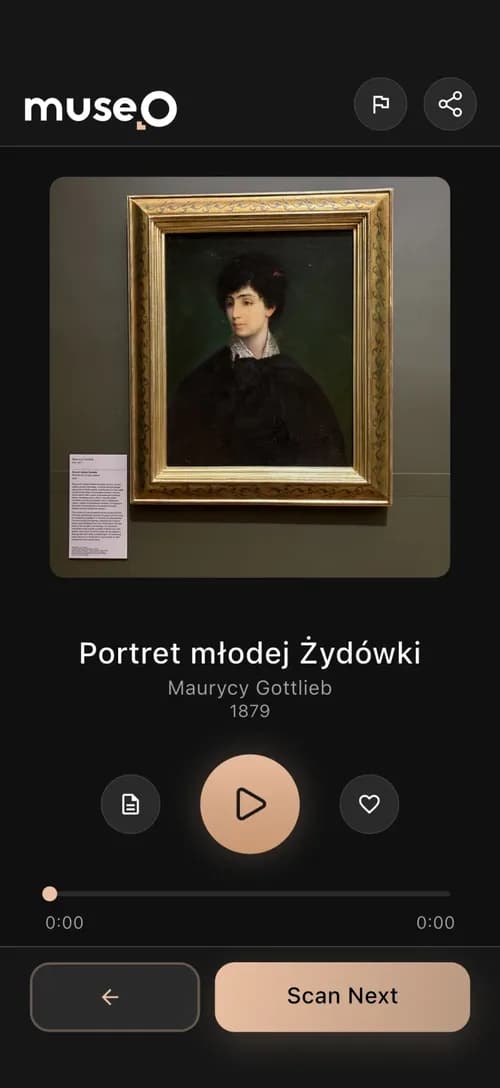
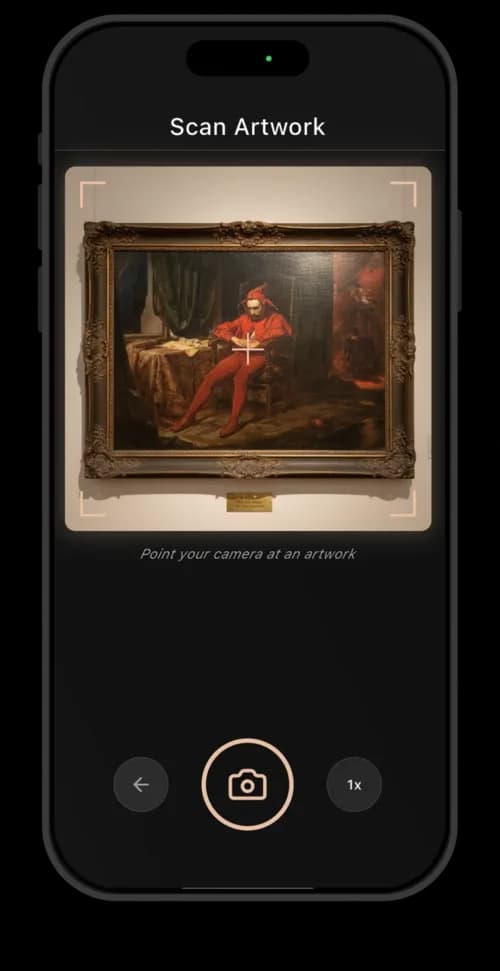
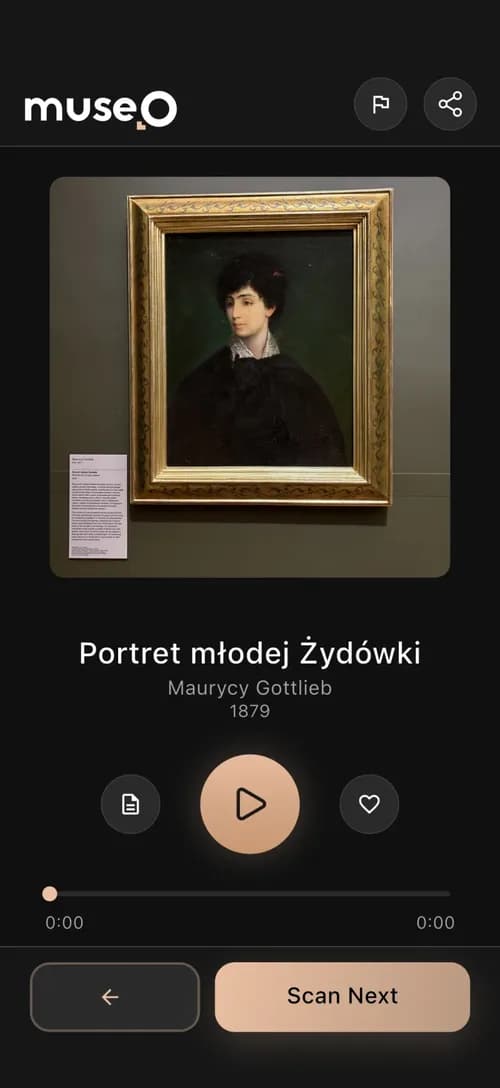
Problem. Museo to aplikacja przewodnik po muzeum: zwiedzający robi zdjęcie dzieła, aplikacja je rozpoznaje i odtwarza jego historię. Rozpoznanie musi być natychmiastowe, ale ruch w muzeum przychodzi falami, a w nocy sale są puste, więc GPU włączone 24/7 płaciłoby głównie za puste sale.
Co zrobiliśmy. Jeden zespół zbudował cały ekosystem 6 elementów: aplikacje we Flutterze na iOS i Androida, panel admina w Next.js i pipeline AI. Do rozpoznawania serwujemy CLIP na RunPod Serverless ze skalowaniem do zera i rozgrzewaniem, które startuje, gdy zwiedzający otwiera skaner.
Efekt. Museo przeszło od koncepcji do działającego produktu w około 3 miesiące. Gdy worker jest rozgrzany, rozpoznaje dzieło w około 100 ms. Gdy muzeum jest zamknięte, rachunek za GPU wynosi zero.
Tak wygląda droga zdjęcia krok po kroku. Telefon przycina zdjęcie do 224x224 pikseli, czyli rozmiaru, którego oczekuje model, i wysyła je do workera na GPU z modelem OpenCLIP ViT-L-14 z wagami OpenAI w FP16 (liczby o połowicznej precyzji: połowa pamięci, praktycznie ten sam wynik). Worker zwraca wektor 768 liczb, sprowadzony do jednej długości (normalizacja L2), żeby wektory dało się uczciwie porównywać. Potem Qdrant, baza wektorowa, która znajduje zapisane wektory najbliższe nowemu, zwraca najbardziej podobne dzieła z katalogu danego muzeum. Jedno zapytanie może zawierać do 50 zdjęć.
Dlaczego to ważne dla twojego budżetu: sama praca GPU trwa ułamek sekundy i kosztuje ułamek centa. Naprawdę płacisz za czas, przez który GPU jest włączone wokół tej pracy. Reszta tekstu mówi o tym, jak ten czas kontrolować.
Jak RunPod Serverless nalicza opłaty? Licznik działa, aż worker całkiem się zatrzyma
W skrócie: RunPod nalicza opłatę za workera serverless od chwili startu do pełnego zatrzymania, zaokrągloną w górę do pełnej sekundy. W tym czasie mieści się ładowanie handlera (funkcji, którą RunPod wywołuje przy każdym zadaniu) i modelu do pamięci GPU, wykonywanie zadań i limit bezczynności po ostatnim zadaniu. Nic nie kosztuje tylko worker, który już się wyłączył i w konsoli ma status Idle.
Prosty obraz: pomyśl o taksówce z włączonym licznikiem. Licznik rusza, gdy taksówka podjeżdża, działa w czasie jazdy i działa dalej, gdy kierowca czeka pod drzwiami na twój następny kurs. Staje dopiero, gdy taksówka odjeżdża. Limit bezczynności w RunPod to właśnie to czekanie pod drzwiami i płacisz za nie za każdym razem.
Obie zasady pochodzą z dokumentacji RunPod: ze strony z cennikiem Serverless (EN) (opłata do pełnego zatrzymania, czas oczekiwania jest płatny, pobieranie obrazu kontenera przy wyłączonym workerze nie) i z opisu konfiguracji endpointu (EN) ("The worker is billed while it waits", czyli worker jest rozliczany, gdy czeka). Są dwa rodzaje workerów. Workery flex startują i zatrzymują się razem z zapytaniami i płacisz za nie standardową stawkę za sekundę. Workery aktywne, ustawiane przez min workers 1 lub więcej, nigdy się nie wyłączają i są rozliczane bez przerwy, niezależnie od tego, czy mają zadania. Rabat na workery aktywne RunPod daje tylko przez dział sprzedaży, bez publicznej stawki.
ViT-L-14 ma około 428 milionów parametrów, więc jego wagi w FP16 zajmują mniej niż 1 GB. Każda klasa z tabeli mieści go z zapasem na paczkę 50 zdjęć. Wyliczenia w tym tekście opierają się na klasie 24 GB za 0,75 USD za godzinę. Ceny się zmieniają, więc przed planowaniem budżetu sprawdź cennik RunPod (EN).
O rachunku decydują cztery ustawienia. Oto, co robi każde z nich i jaką ma wartość domyślną:
- Limit bezczynności (idle timeout): jak długo worker czeka na kolejne zadanie, zanim się wyłączy. Domyślnie 5 sekund w konsoli i 10 sekund przez REST API v2. Zawsze płatny w całości.
- FlashBoot: zachowuje stan workera po wyłączeniu, więc wraca szybciej niż przy starcie od zera. Domyślnie włączony w konsoli, wyłączony w REST v2.
- Max workers: ile kopii RunPod może uruchomić naraz. Domyślnie 3. Ta wartość domyślna jeszcze da o sobie znać w tym tekście.
- Zimny start: pobieranie obrazu przy wyłączonym workerze jest darmowe. Ładowanie modelu do pamięci GPU jest płatne, więc wbuduj wagi w obraz kontenera i ładuj je raz, poza handlerem.
Co to oznacza dla ciebie: każde zapytanie, które budzi wyłączonego workera, płaci za załadowanie modelu i za czas oczekiwania, a nie tylko za ułamek sekundy prawdziwej pracy. Skróć jedno i drugie, a rachunek spadnie razem z nimi.
Czy ping keep-alive tanio utrzymuje workera w gotowości? Nie: 2 USD na papierze, 1095 USD na fakturze
W skrócie: nie. Worker pingowany co 50 sekund przy limicie bezczynności 60 sekund nigdy nie dochodzi do końca limitu, więc nigdy się nie wyłącza, a RunPod rozlicza każdą sekundę miesiąca w stawce flex. Za dwa workery 24 GB to około 1095 USD miesięcznie, a nie 2 USD, które obiecuje ten trik.
Pomysł polega na tym, żeby co 50 sekund wysyłać malutkie zadanie, dzięki czemu worker nigdy nie stygnie. W obrazie z taksówką to dzwonienie do kierowcy co 50 sekund z prośbą "poczekaj jeszcze chwilę". Taksówka nigdy nie odjeżdża, a licznik bije całą noc. Na papierze pomysł wygląda dobrze, bo kwota 2 USD liczy tylko czas samych pingów, około 0,1 sekundy każdy:
Ping nigdy więc nie jest tańszy od workerów aktywnych. W najlepszym razie kosztuje tyle samo, a jeśli dział sprzedaży da ci rabat na workery aktywne, ping wychodzi drożej. Ma też dwie inne wady. Jeden ping trafia do jednego workera, więc drugi się wyłącza, chyba że wysyłasz pingi równolegle. A każdy ping to zadanie w kolejce i w logach. Jeśli naprawdę potrzebujesz workera gotowego całą dobę, ustaw min workers na 1 i świadomie przyjmij ten koszt.
Ryzyko dla biznesu: pozycja 1095 USD za GPU tam, gdzie plan mówił 2 USD, to niespodzianka, po której właściciel przestaje wierzyć całej wycenie. Zapytaj zespół, który buduje twoją aplikację, jak rozliczane jest rozgrzewanie, zanim trafi na produkcję, a nie po pierwszej fakturze.
Co działa na produkcji: skalowanie do zera i rozgrzewanie, gdy zwiedzający otwiera skaner
W skrócie: płać za rozgrzane GPU tylko wtedy, gdy użytkownik naprawdę może wysłać zdjęcie. Endpoint Museo ma min 0 workerów (żaden nie działa, gdy nikogo nie ma), max 5 (najwyżej pięć kopii w szczycie), limit bezczynności 5 sekund i włączony FlashBoot. Gdy ktoś się loguje albo otwiera skaner, backend podnosi min workers do 1. Gdy przez 120 sekund nikt nic nie robi, zaplanowane zadanie ustawia z powrotem 0.
Worker na GPU: pięć zasad, dzięki którym zimny start jest krótki i tani
Worker to mały program na GPU, który przyjmuje zdjęcia i zwraca wektory. Te pięć zasad decyduje o tym, jak szybko startuje i jak mało kosztuje każde zapytanie:
- Wbuduj model w obraz kontenera. Wagi OpenCLIP są w środku kontenera. Przy starcie nic się nie pobiera, a płatna część zimnego startu to tylko załadowanie niecałego 1 GB do pamięci GPU.
- Ładuj raz, przy imporcie. Utwórz model, przełącz go na FP16, wywołaj eval() i przenieś na GPU w zasięgu modułu, poza funkcją handlera, żeby ciepłe zadania nigdy za to nie płaciły.
- Najpierw odpowiadaj na {"ping": true}. Jeśli wejście zadania to ping, zwróć wynik od razu, bez dotykania modelu. Backend używa tego jako sprawdzenia, że worker działa.
- Koduj paczkami. Zdekoduj do 50 zdjęć, które telefon już przyciął do 224x224, uruchom encode_image w trybie no_grad (samo wnioskowanie, bez narzutu na trening), znormalizuj każdy wektor L2 i zwróć 768 liczb na zdjęcie.
- Szukaj poza GPU. Backend wysyła wektor do Qdrant, bierze 5 najlepszych wyników według podobieństwa cosinusowego (jak bardzo dwa wektory wskazują ten sam kierunek) i przyjmuje dopasowanie tylko powyżej progu (0,60 w naszym teście opisanym niżej).
Rozgrzewanie: cztery kroki od pierwszego skanu z powrotem do zera
Rozgrzewanie to kilka linijek logiki w backendzie i zadanie cron, czyli zadanie uruchamiane według harmonogramu, tutaj co 5 minut. Razem robią to:
- Logowanie albo skanerBackend zapisuje czas ostatniej aktywności użytkownika. Jeśli endpoint ma min 0 workerów, wywołuje saveEndpoint w RunPod z workersMin: 1 i resztą obecnej konfiguracji.
- W czasie skanowaniaKażde zapytanie aktualizuje czas ostatniej aktywności. Ciepły worker odpowiada bez zimnego startu, a większy ruch skaluje się do 5 workerów.
- Co 5 minutZadanie cron sprawdza czas ostatniej aktywności. Jeśli przez 120 sekund nikt nie był aktywny, a min workers wynosi 1, wywołuje saveEndpoint z workersMin: 0.
- 5 s późniejBez zadań i z min workers na 0 worker dochodzi do 5-sekundowego limitu bezczynności i się zatrzymuje. Razem z nim zatrzymuje się naliczanie opłat.
Pułapka, na którą trafiliśmy: mutacja GraphQL saveEndpoint w RunPod (wywołanie API, które zmienia ustawienia endpointu) tworzy i aktualizuje endpointy, a z naszego doświadczenia aktualizacja przywraca wartości domyślne we wszystkich polach, których nie wyślesz. Wyślesz tylko workersMin, a workersMax po cichu spada z 5 do domyślnych 3, więc ruch w szczycie czeka w kolejce bez żadnego błędu. Dokumentacja GraphQL dla endpointów (EN) nie mówi, co dzieje się z pominiętymi polami. Najpierw odczytaj obecną konfigurację, zmień jedno pole, odeślij całość i zapisz w logach, co zwróciło API.
Ile kosztuje jedna sesja? Gdy min workers wynosi 1, worker nalicza każdą sekundę. Po ostatnim skanie płacisz za 120 sekund zapasu i do 5 minut do kolejnego uruchomienia crona: od 2 do 7 minut, czyli około 0,03-0,09 USD na klasie 24 GB. Miejsce z odwiedzającymi przez 8 godzin dziennie trzyma rozgrzanego workera przez około 240 godzin w miesiącu, czyli za około 180 USD. Ten sam worker rozgrzany całą dobę kosztuje 547,50 USD. W nocy rachunek wynosi zero.
Zapytania spoza sesji też działają: RunPod uruchamia workera na żądanie. Każde pojedyncze zapytanie to mniej więcej 6 do 10 płatnych sekund: ładowanie modelu, zadanie i 5 sekund bezczynności na końcu. Przy 0,000208 USD za sekundę daje to około 0,0013-0,002 USD za zapytanie.
Co zyskujesz: natychmiastowy pierwszy skan dla każdego zwiedzającego, rachunek za GPU, który podąża za godzinami otwarcia, i brak ukrytej kolejki w szczycie. Czas, pieniądze i ryzyko załatwione jednym małym kawałkiem backendu.
Czy gotowy model CLIP rozpoznaje wystarczająco dobrze? 93,5% precyzji w naszym teście Museo
W skrócie: do rozpoznawania znanych obiektów z katalogu często tak, bez dotrenowywania. Gotowy (pretrained) oznacza, że użyliśmy publicznego modelu tak, jak jest, bez dodatkowego uczenia na obrazach z muzeum. W jednym teście konfiguracji Museo, przy progu podobieństwa 0,60 i 5 najlepszych wynikach, zmierzyliśmy 93,5% precyzji, 85,8% czułości, wynik F1 89,5% i 1,8% fałszywych alarmów.
Co znaczą te liczby prostymi słowami. Precyzja: gdy aplikacja nazwała dzieło, miała rację 93,5 razy na 100. Czułość (recall): z dzieł, które powinna rozpoznać, znalazła 85,8 na 100. F1 to jedna liczba, która równoważy obie. Odsetek fałszywych alarmów liczy pewne siebie, błędne dopasowania, czyli odpowiedzi, których zwiedzający nie powinien dostać nigdy.
- Próg to decyzja produktowa. Wyższy próg zmniejsza liczbę fałszywych alarmów i zwiększa liczbę odpowiedzi "nie rozpoznano". W muzeum błędne dzieło z pewną siebie narracją jest gorsze niż prośba o ponowne zdjęcie.
- Mierz na swoich obiektach. Jeden test na jednej kolekcji to nie benchmark. Zbierz opisany zestaw prawdziwych zdjęć z telefonów, pod prawdziwymi kątami i w prawdziwym świetle, i powtarzaj test po każdej zmianie modelu albo progu.
- Katalog i zapytania na jednym modelu. Wektory z różnych modeli żyją w różnych przestrzeniach. Zmieniasz model, przeliczasz od nowa cały katalog.
Na produkcji Museo rozpoznaje dzieło w około 100 ms, gdy worker jest rozgrzany. Właśnie dlatego rozgrzewanie jest tak ważne: zimny start przed obrazem to moment, w którym zwiedzający się poddaje. Dla twojego biznesu trafność i szybkość to jedno: decydują, czy ludzie będą korzystać z funkcji, za którą zapłaciłeś.
Ile kosztuje 1000 embeddingów obrazów CLIP? Dziewięć opcji od 0 do około 20 USD
W skrócie: w przeliczeniu na zapytanie najtańsze są gotowe API: około 0,22 USD za 1000 wywołań publicznego modelu CLIP na Replicate i 0,12 USD za Gemini Embedding 2. Własne serverless GPU kosztuje więcej za pojedyncze zapytanie, około 1,30-2,00 USD za 1000 na RunPod, ale daje ci kontrolę nad modelem, czasem odpowiedzi i danymi. Oto pełny obraz.
Dwa pojęcia z tabeli: ONNX to format, który pozwala uruchomić model na zwykłym procesorze (CPU) zamiast GPU, a 503 to błąd, który serwer zwraca, gdy jeszcze się uruchamia.
Źródła, wszystkie sprawdzone w listopadzie 2026: cennik Modal (EN) i jego poradnik o zimnych startach (EN) (bezczynne kontenery w oknie wygaszania są płatne; okno trwa od 2 sekund do 20 minut, domyślnie 60 sekund), strona modelu clip-features (EN) i rozliczenia Replicate (EN), cennik Gemini API (EN), cennik Inference Endpoints (EN) i autoskalowanie (EN), karta modelu MobileCLIP2 (EN) oraz katalog modeli Workers AI (EN).
Modal czy RunPod: ten sam model, podobny rachunek
W skrócie: stawki za sekundę są zbliżone, więc o rachunku decyduje okno bezczynności. Ten sam model uruchomiliśmy też na Modal: T4, jeden kontener buforowy i okno wygaszania 120 sekund (tak Modal nazywa czas oczekiwania). Za sekundę T4 na Modal (0,000164 USD) kosztuje mniej więcej tyle co klasa 16 GB w RunPod (0,000161 USD). Modal nalicza okno wygaszania tak, jak RunPod limit bezczynności, a kontener buforowy to jeszcze jeden ciepły kontener płatny, gdy funkcja jest aktywna. Przy tych samych oknach oba rachunki wychodzą podobnie. Wybieraj według wygody pracy zespołu i dostępności GPU, a nie stawki za sekundę.
MobileCLIP2 na telefonie: zero rachunku za GPU, ale inne kompromisy
W skrócie: embeddingi liczone na urządzeniu całkowicie usuwają rachunek za GPU, ale płacisz w inny sposób. Karta modelu Apple podaje 1,5 ms dla kodera obrazu MobileCLIP2-S0 i 71,5% trafności zero-shot na ImageNet, wobec 57,9 ms i 81,9% dla MobileCLIP2-L/14. Karta nie mówi, z jakiego urządzenia pochodzą te czasy, więc zmierz je na najtańszym telefonie, który wspierasz. Cena to przeliczony od nowa katalog (każdy model rysuje własną mapę wyglądu, więc adresy z jednej mapy nic nie znaczą na drugiej), większa aplikacja i aktualizacja modelu z każdym wydaniem aplikacji.
Która konfiguracja pasuje do twojego ruchu? Sześć wzorców ruchu i najlepszy wybór dla każdego
W skrócie: wybieraj według kształtu ruchu, a nie stawki za sekundę. Sesje z długimi przerwami przemawiają za skalowaniem do zera z rozgrzewaniem. Równy ruch przez cały dzień przemawia za stale włączonym workerem. Jednorazowy import katalogu przemawia za tańszym trybem batch na tym samym modelu, którym potem będziesz wyszukiwać.
Zanim wybierzesz, policz próg opłacalności, czyli punkt, w którym dwie opcje kosztują tyle samo. Jeden worker 24 GB włączony cały czas w stawce flex kosztuje 547,50 USD miesięcznie. Rozgrzewanie na sesję wygrywa, dopóki liczba ciepłych godzin jest wyraźnie niższa niż 730 w miesiącu. Jeśli aplikacja jest zajęta codziennie od rana do północy, i tak jesteś blisko pracy ciągłej, a wynegocjowana stawka za workera aktywnego to lepszy interes.
Kto powinien wbudować rozpoznawanie obrazów w twoją aplikację? Seniorzy, którzy mają je już na produkcji
W skrócie: wybierz zespół, który pokaże działający produkt z rozpoznawaniem obrazów i wytłumaczy rachunek za GPU pozycja po pozycji. My pokazujemy jedno i drugie: Museo rozpoznaje dzieło w około 100 ms na produkcji, a każda liczba w tym tekście pochodzi z jego konfiguracji. Demo, które rozpoznaje dziesięć przedmiotów na laptopie, niewiele mówi o zimnych startach, opłatach za bezczynność, progach i katalogu z tysiącami pozycji.
Sześć pytań do każdego zespołu i nasze odpowiedzi
- Dowód z produkcji. Czy pokażą działającą aplikację, a nie notatnik z kodem? Nasza to Museo: ekosystem 6 elementów, od koncepcji do działającego produktu w około 3 miesiące, rozpoznanie dzieła w około 100 ms.
- Znajomość rozliczeń. Zapytaj, kiedy worker serverless przestaje być rozliczany. Jeśli odpowiedź brzmi "gdy skończy się zadanie", spodziewaj się triku z pingiem na fakturze. Nasza odpowiedź to rozgrzewanie na sesję opisane wyżej: zero w nocy, około 180 USD miesięcznie dla miejsca otwartego 8 godzin dziennie.
- Zmierzona trafność. Poproś o precyzję, czułość i odsetek fałszywych alarmów na twoich zdjęciach, razem z progiem, który dał te wyniki. Nasze: 93,5% precyzji przy progu 0,60 w jednym teście Museo.
- AI w więcej niż jednej działającej aplikacji. W Assuranci, aplikacji do ubezpieczeń samochodowych, którą zbudowaliśmy, model wizyjny odczytuje dane auta z jednego zdjęcia dowodu rejestracyjnego. Poniżej 50% pewności aplikacja prosi o nowe zdjęcie, zamiast zgadywać. Od pierwszego commita do App Store minęły 4 miesiące.
- Myślenie o produkcie wokół modelu. Skaner to tylko jeden ekran. Dla Museo przed budową przetestowaliśmy 49 wariantów ekranu głównego i ponad 30 ekranów, co pokazujemy w opisie projektowania Museo.
- Stała cena. Wyceniamy każdy etap z góry, zanim ruszy: audyt aplikacji z konkretnym planem to 17 500-28 000 zł netto, MVP albo premiera aplikacji od 50 000 zł netto. Wszystkie kwoty znajdziesz w naszym cenniku.
Dlaczego mały zespół seniorów to bezpieczniejszy wybór przy funkcji na GPU
Funkcja na GPU psuje się na szczegółach: limit bezczynności 60 sekund zamiast 5, wywołanie ustawień, które po cichu zbija max workers do 3, próg, którego nikt nie sprawdził na prawdziwych zdjęciach. U nas o tych szczegółach decydują seniorzy, z którymi rozmawiasz. Nie ma warstw opiekunów klienta, którzy przekazują wiadomości dalej, więc na pytanie o rachunek odpowiada ktoś, kto czytał kod, zwykle jeszcze tego samego dnia.
Pracujemy też nad tym, co dzieje się z obrazem na telefonie. Wśród naszych paczek open source dla Fluttera są camera_extended i flutter_bicubic_resize, która zmienia rozmiar, przycina i kompresuje zdjęcia na urządzeniu w natywnym C. Obie znajdziesz na naszej stronie open source. Klienci opisują współpracę z nami na Clutchu, gdzie mamy ocenę 5,0 z 19 opinii i nagrodę Top Flutter Developers Poland 2026. W opinii o MVP, które zbudowaliśmy dla FishPRO, czytamy: "They immediately knew which mistakes to avoid, and their product suggestions were accurate and insightful." Po polsku: od razu wiedzieli, jakich błędów unikać, a ich sugestie produktowe były trafne i przemyślane.
Jeśli potrzebujesz tylko drugiej opinii o konfiguracji endpointu albo o rachunku, zapytaj nas na stronie "Zbuduj z AI": pytania są bezpłatne, a odpowiedzi publikujemy. Jeśli liczysz budżet całej aplikacji, a nie tylko GPU, przeczytaj, ile kosztuje stworzenie aplikacji mobilnej.
Częste pytania
01Czy RunPod Serverless nalicza opłatę za limit bezczynności?
Tak. RunPod rozlicza workera od startu do pełnego zatrzymania, z zaokrągleniem w górę do sekundy, a limit bezczynności po ostatnim zadaniu wlicza się w ten czas. Darmowy jest tylko worker, który już się wyłączył (stan na listopad 2026).
02Czy mogę utrzymać workera RunPod w gotowości pingami?
Możesz, ale to nie jest tanie. Worker pingowany częściej, niż wynosi jego limit bezczynności, nigdy się nie wyłącza, więc płacisz za niego 24/7: około 547,50 USD miesięcznie za jednego workera 24 GB. Ustawienie min workers na 1 kosztuje tyle samo albo mniej, a o rabat na workera aktywnego możesz zapytać dział sprzedaży RunPod.
03Jak długo trwa zimny start CLIP na RunPod?
To zależy od GPU, obrazu kontenera i tego, czy FlashBoot może wskrzesić workera. Płatne jest tylko ładowanie modelu do pamięci GPU, a nie pobieranie obrazu. Wbuduj wagi w obraz i ładuj je poza handlerem. Przy skanach, na które czeka użytkownik, rozgrzewaj workera na początku sesji, zamiast liczyć na krótki zimny start.
04Czy Modal jest tańszy od RunPod przy embeddingach CLIP?
Za sekundę są blisko: T4 na Modal kosztuje 0,000164 USD, a klasa 16 GB w RunPod 0,000161 USD (stan na listopad 2026). Rachunek zależy od okna po ostatnim zapytaniu. Okno wygaszania w Modal domyślnie trwa 60 sekund, a limit bezczynności w konsoli RunPod 5 sekund, i oba są płatne.
05Czy mogę mieszać wektory CLIP od różnych dostawców w jednym indeksie?
Tylko wtedy, gdy oba używają tych samych wag i tego samego przygotowania zdjęć, a i tak przetestuj to, zanim zaufasz wynikom. Gemini Embedding 2 i MobileCLIP2 tworzą inne przestrzenie wektorów, więc przejście na nie oznacza przeliczenie całego katalogu.
06Ile kosztuje wbudowanie rozpoznawania obrazów w aplikację z Codigee?
Wyceniamy każdy etap ze stałą ceną, ustaloną przed startem prac. Audyt aplikacji z konkretnym planem kosztuje 17 500-28 000 zł netto, a MVP albo premiera aplikacji zaczyna się od 50 000 zł netto. Przed budową dostajesz też od seniorów, którzy by ją robili, miesięczną wycenę GPU dla twojego ruchu, więc rachunek nie zaskoczy.
Czy ten artykuł był przydatny?
5,0 / 5 · 5 ocen