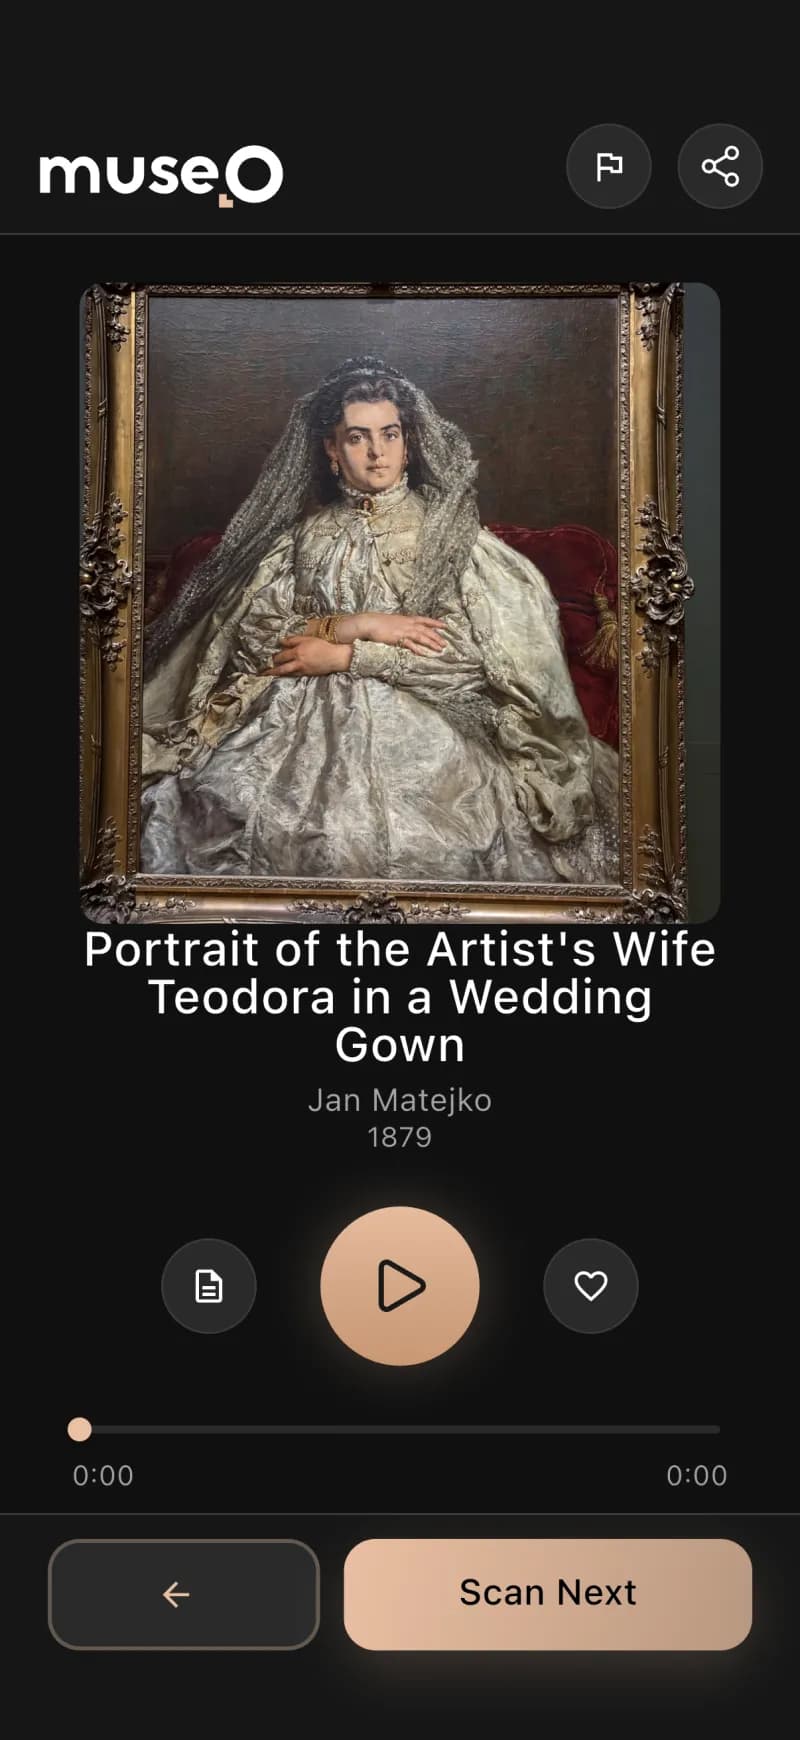
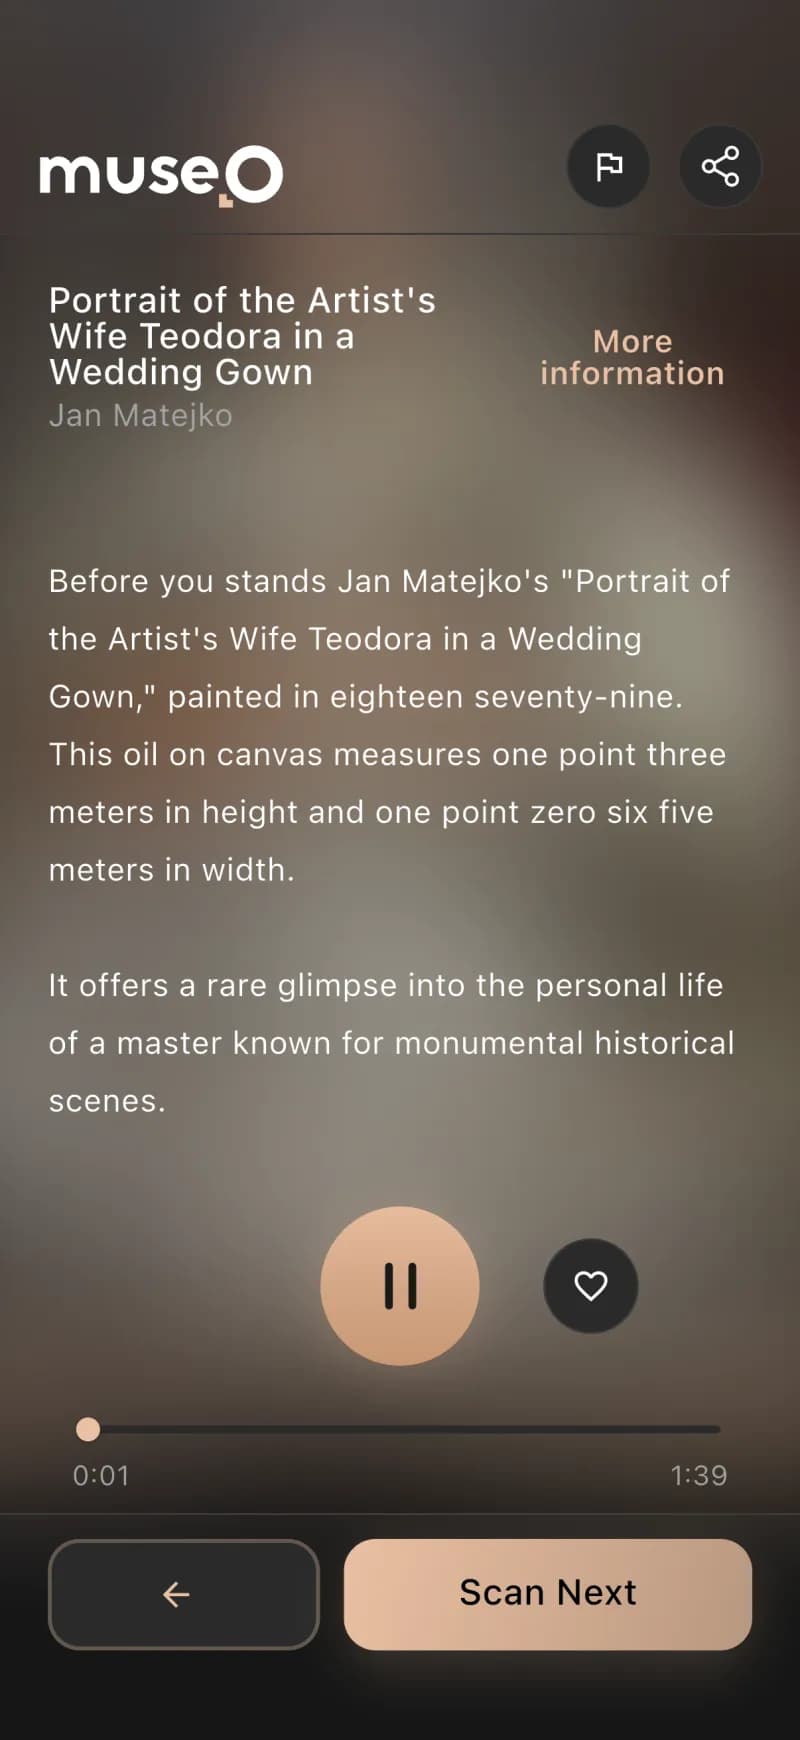
Ljudguidesystem för museer
Skanna ett konstverk. Hör historien på en sekund.

~3 mån
koncept → produkt
6
komponenter, ett ekosystem
20+
språk med AI-berättarröst
28
språk i appgränssnittet
Byggt med: hela teknikstacken
- Flutter / Dart
- flutter_bloc
- go_router
- dio + retrofit
- just_audio
- Firebase + Sentry
- Bun + Elysia
- PostgreSQL + PostGIS
- Drizzle ORM
- Redis + BullMQ
- Better Auth
- Next.js
- Egentränad visionsmodell
- PyTorch
- Whisper
- Serverless GPU
- Docker

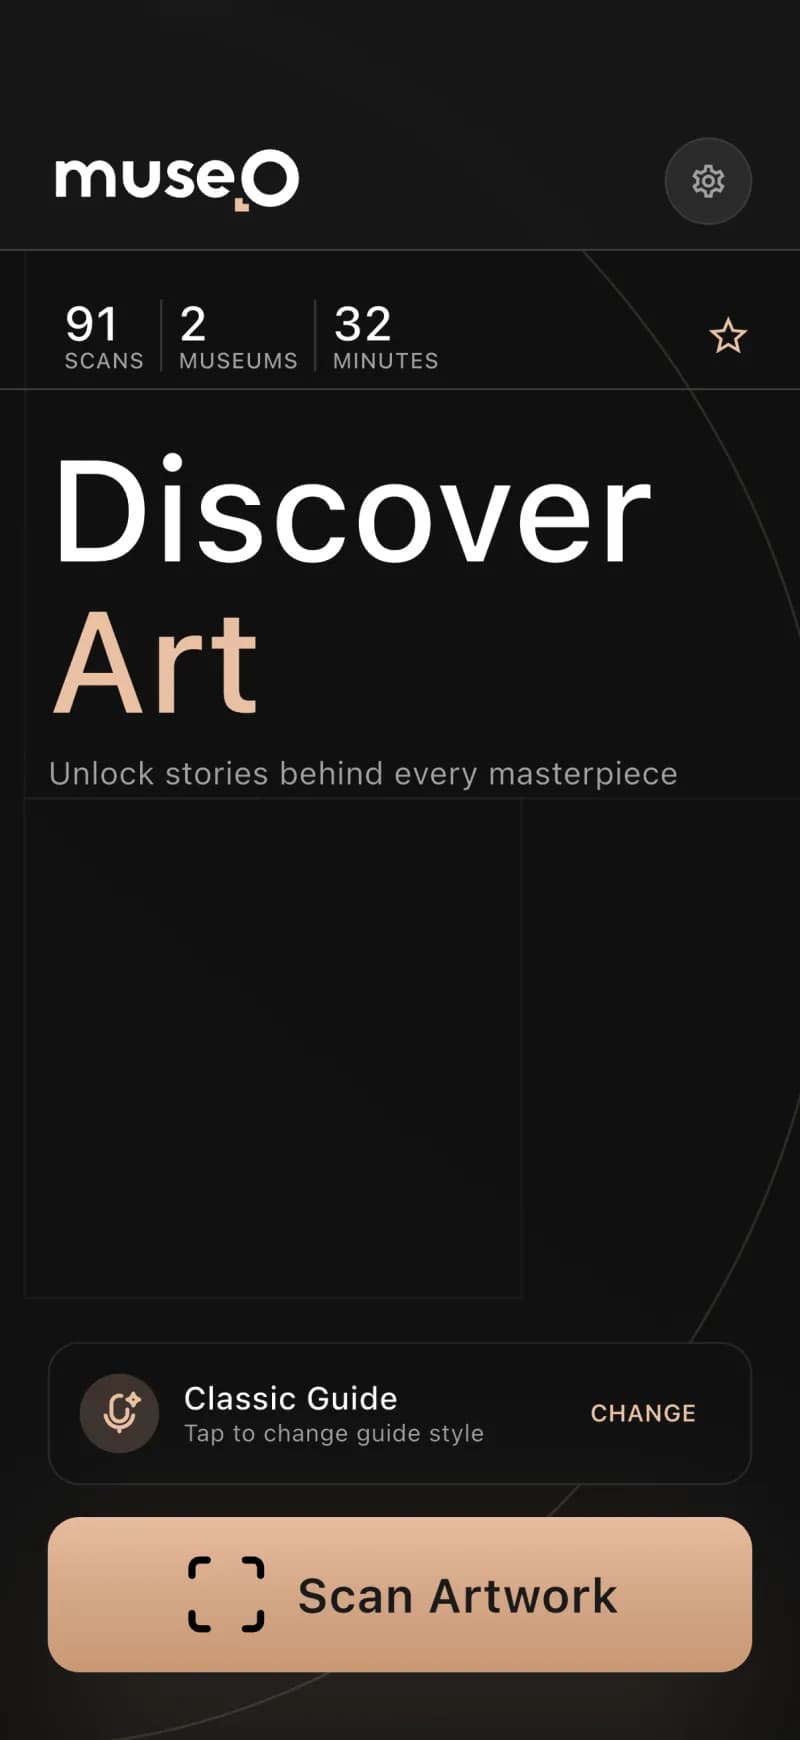
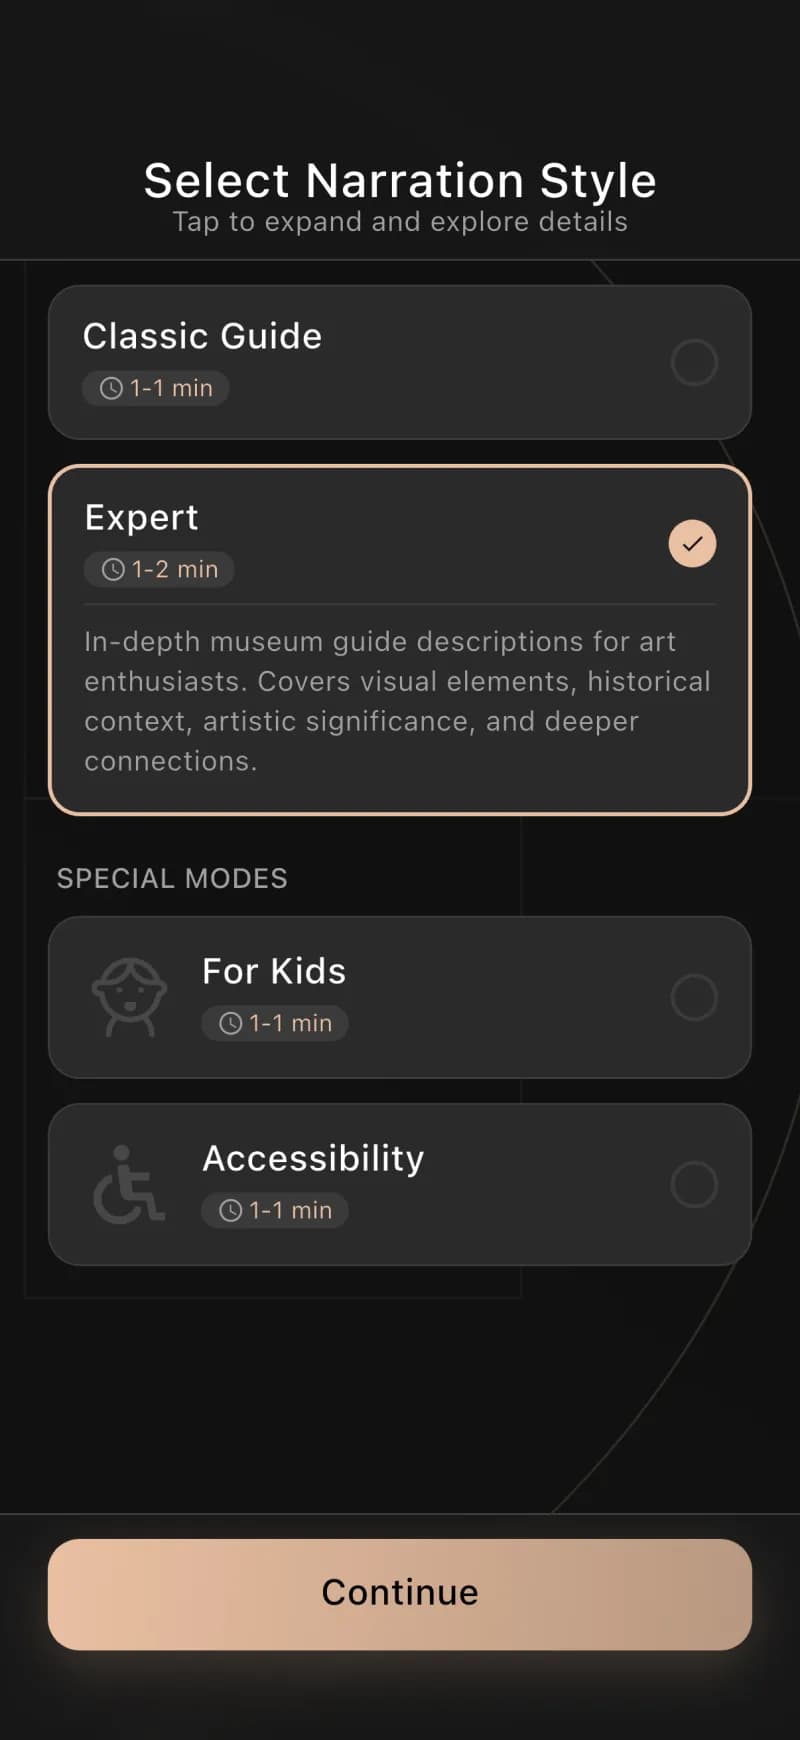
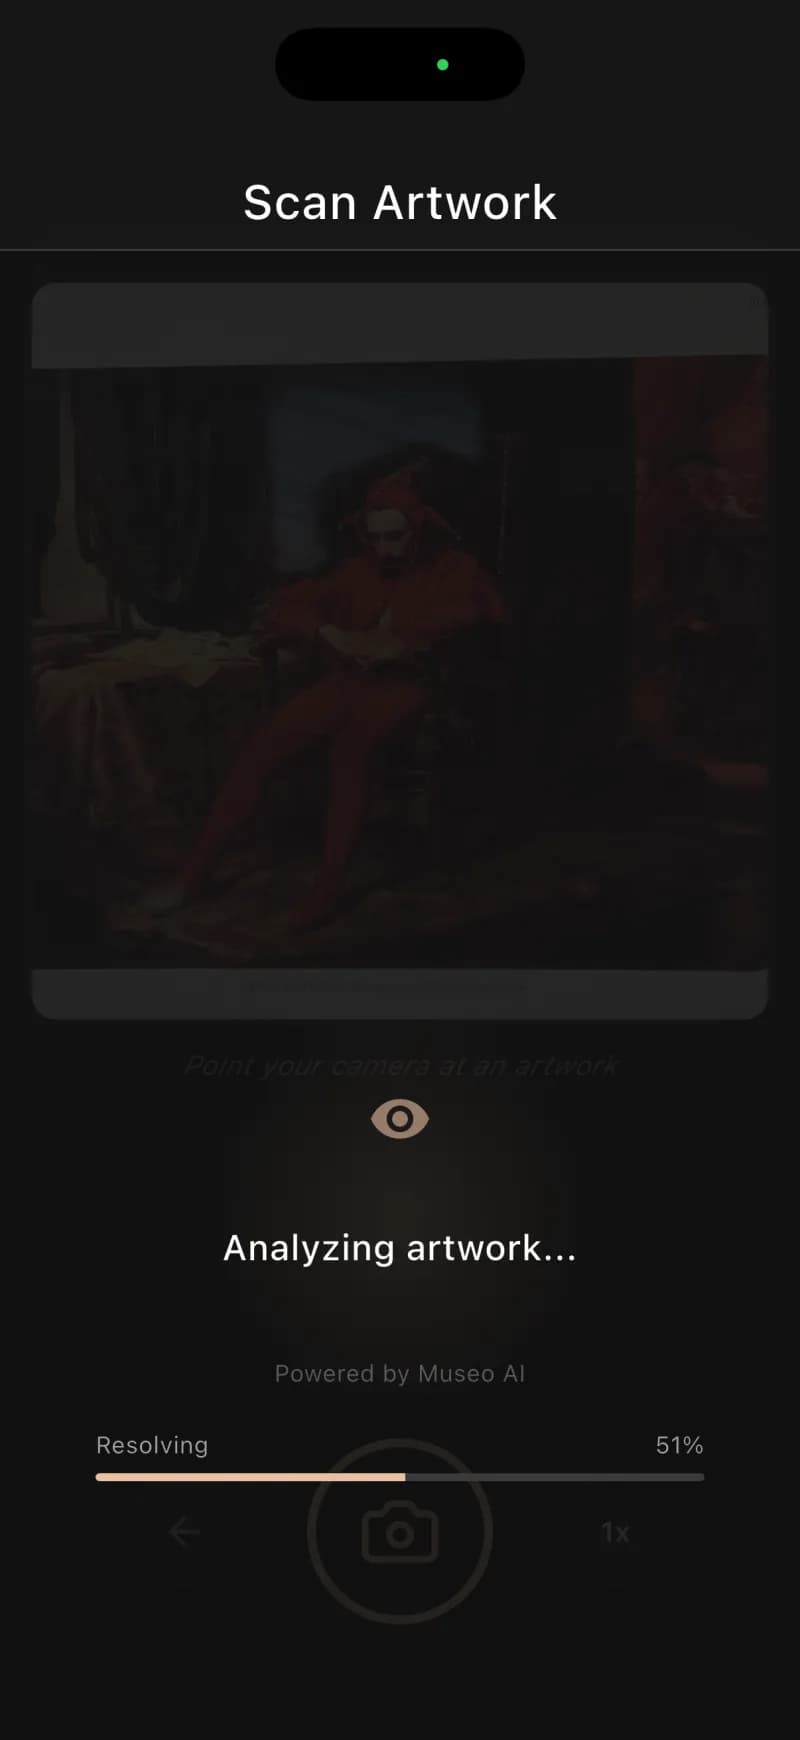
Peka. Känn igen. Lyssna.
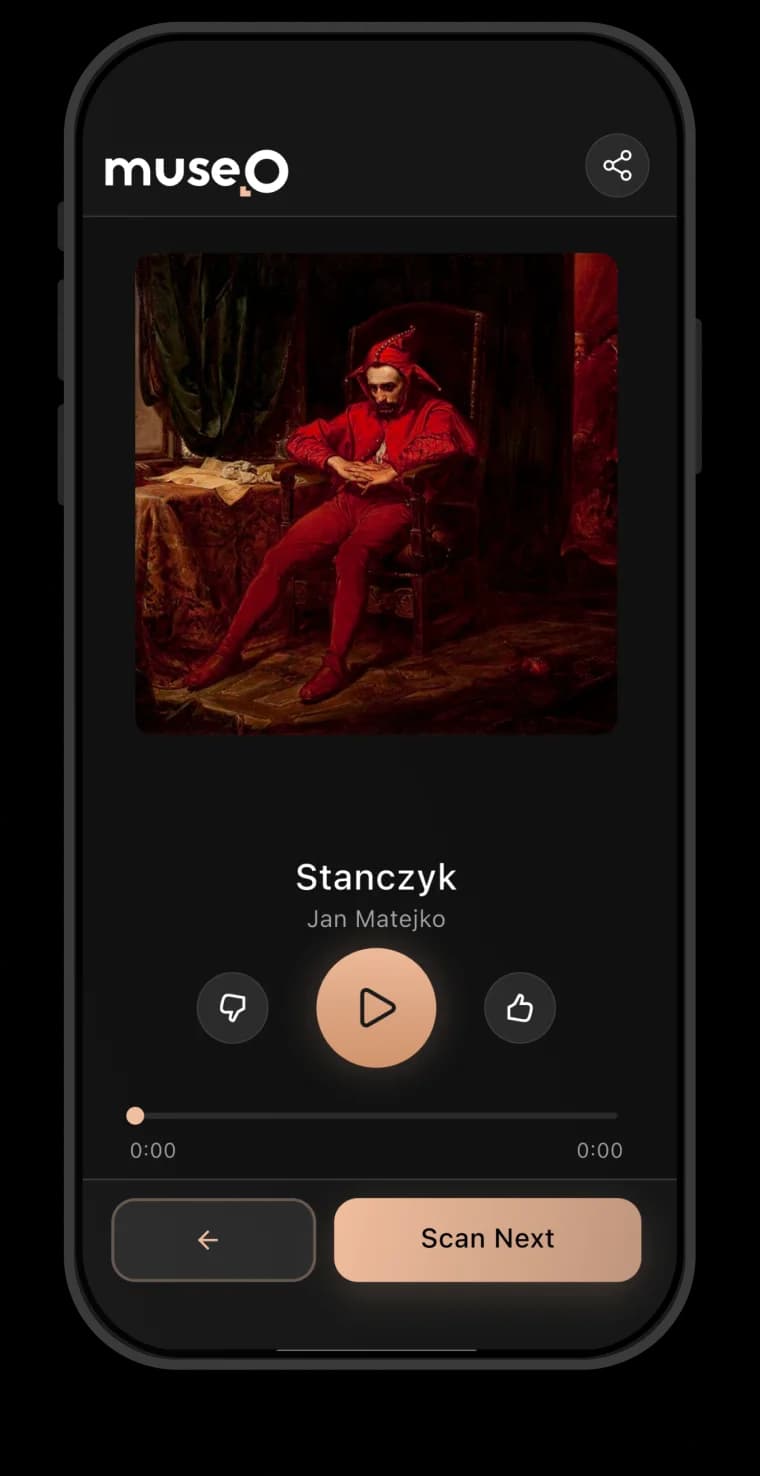
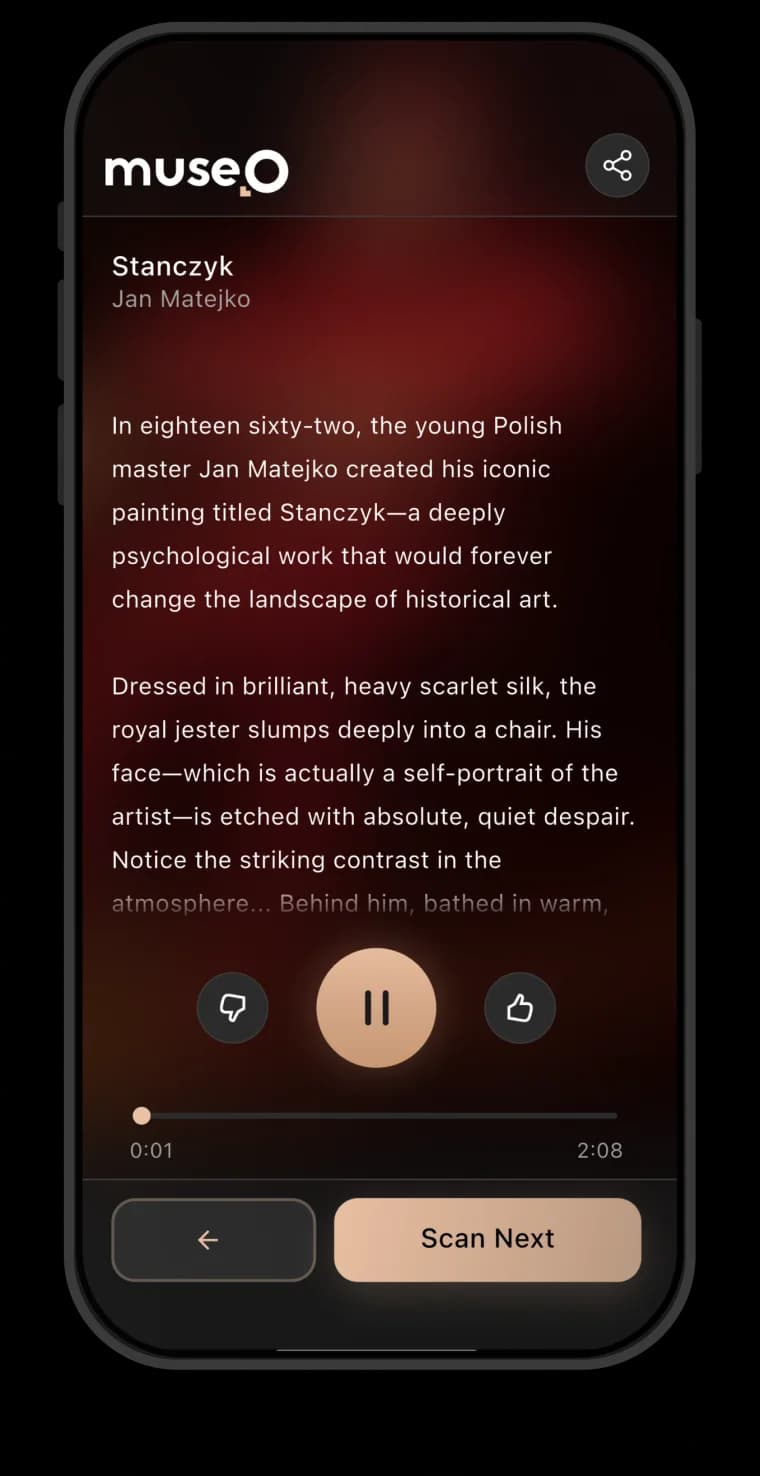
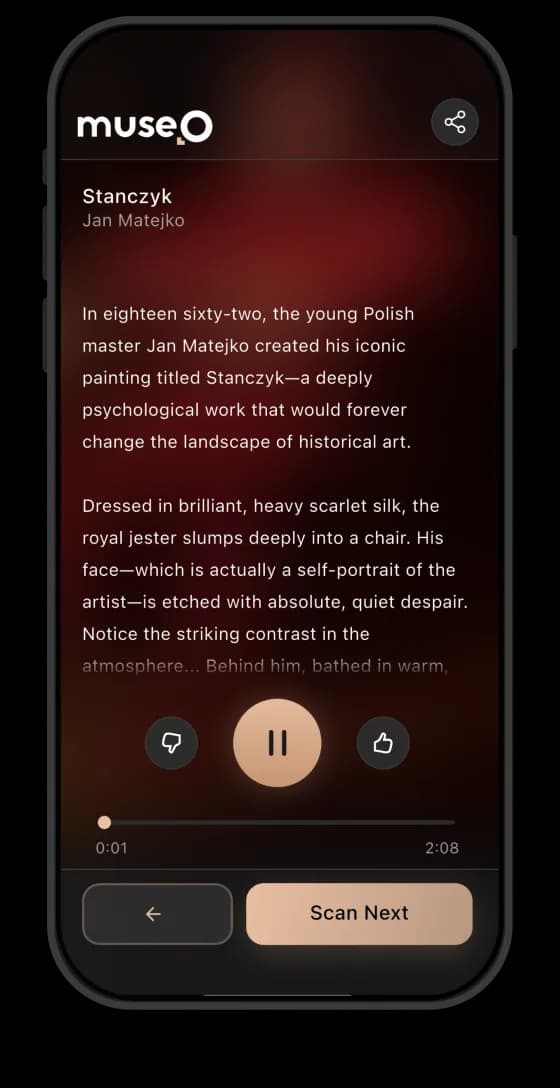
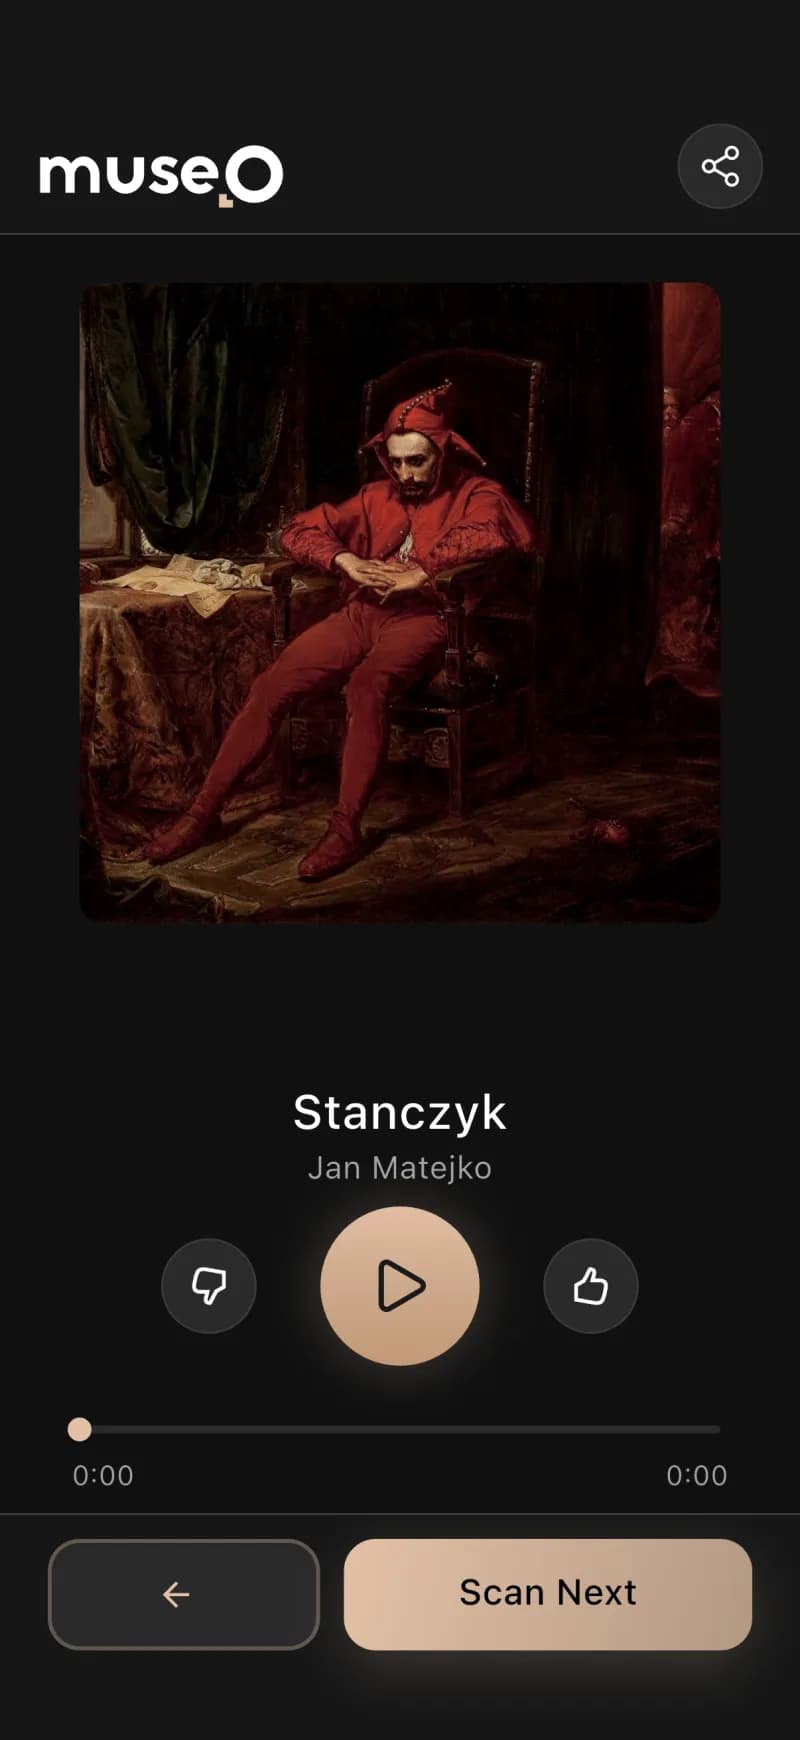
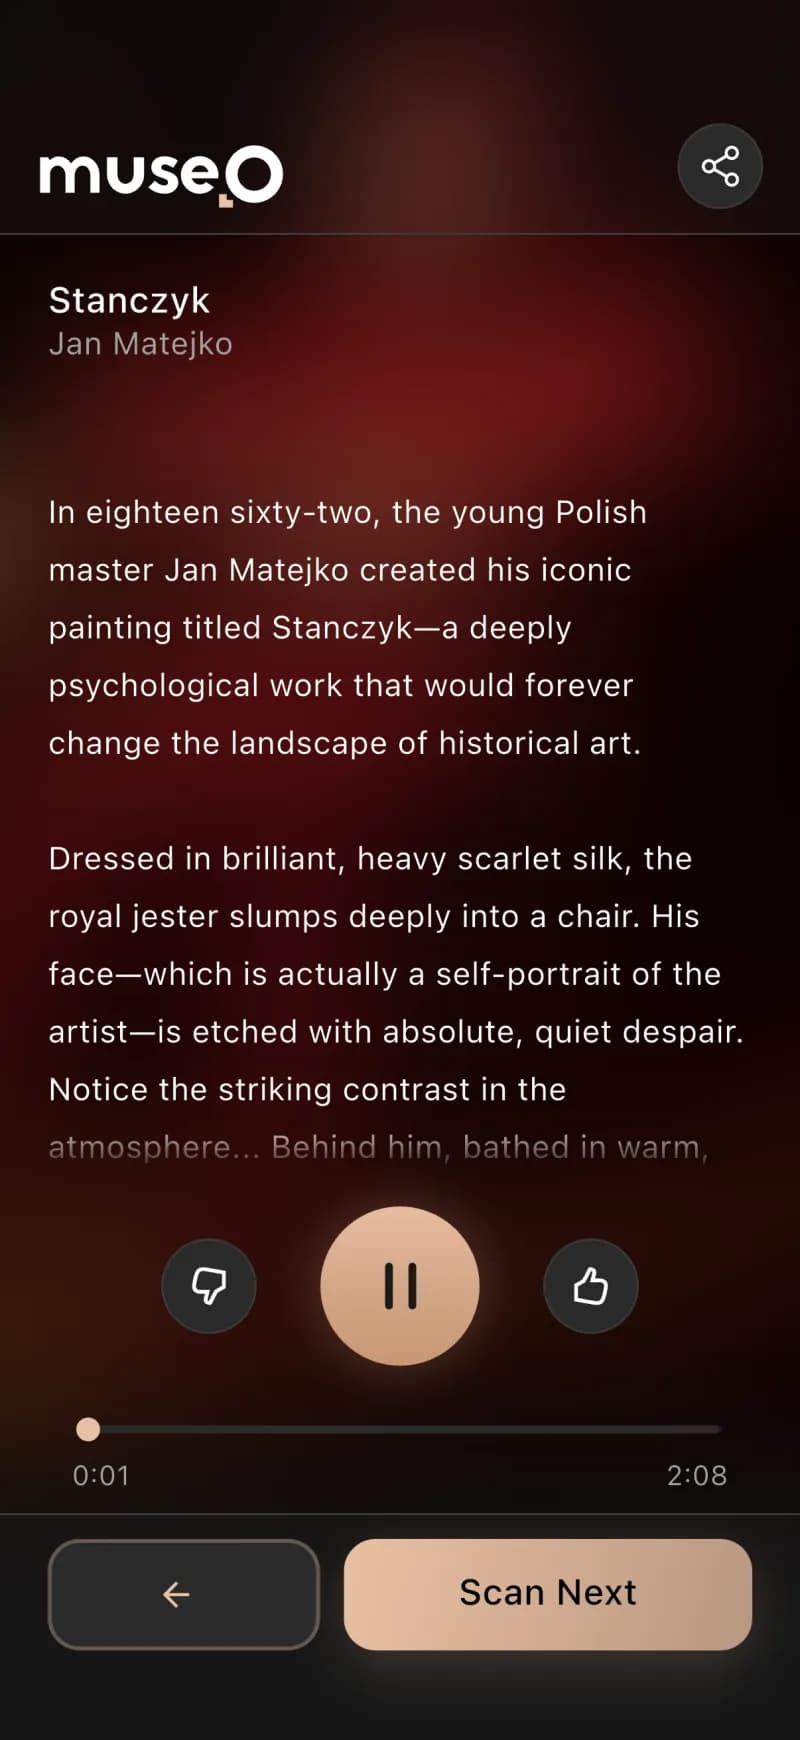
Jan Matejko · 1862 · Nationalmuseet i Warszawa
Läs AI-berättelsen (på engelska)
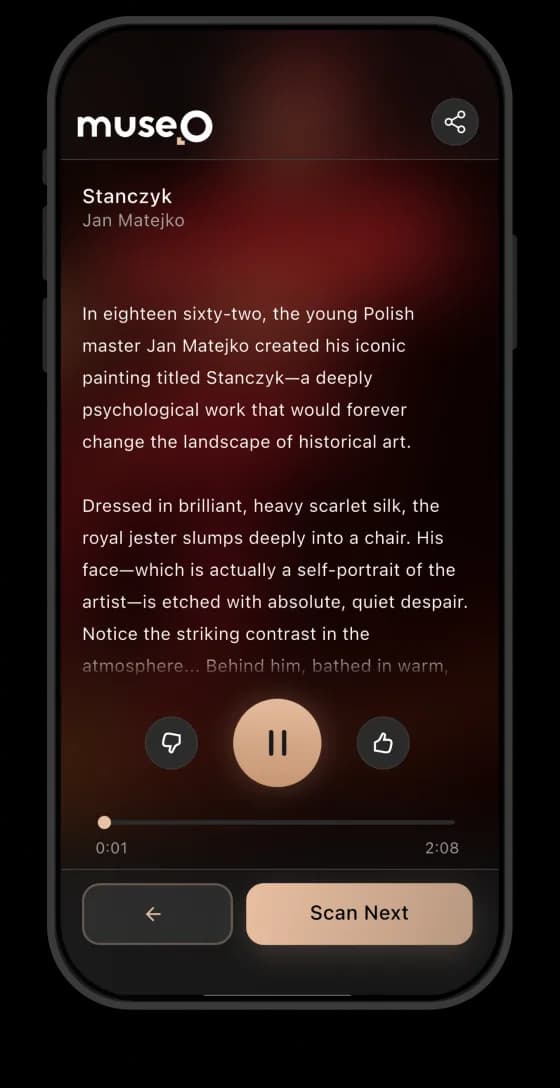
Before you stands "Stańczyk," a profound oil on canvas by Jan Matejko from eighteen sixty-two. This large history painting measures one hundred twenty centimeters by eighty-eight centimeters. It captures a moment of solemn contemplation.
The painting depicts the historical court jester, Stańczyk, in a dark, secluded room. He slumps, lost in thought, his usually jovial role abandoned with his marotte on the floor.
A holy medallion of the Black Madonna of Częstochowa rests on his chest. Through an open window, Krakow's Wawel Cathedral stands dark under a sky with a comet, a symbol of ill omen.
In the background, a lively court ball unfolds, starkly contrasting Stańczyk's isolation.
Matejko, only twenty-four when he painted this, used his own face for the jester, adding a deeply personal touch. The painting symbolizes Poland's dire political situation in the nineteenth century.
Stańczyk's despair reflects the nation's hopelessness under foreign partitions.
The letter on the table is key; it announces the loss of Smolensk to Russia in fifteen fourteen. Matejko included an anachronistic date of fifteen thirty-three on the letter, sparking scholarly debate.
This piece is a flagship work for the National Museum in Warsaw, surviving Nazi looting and Soviet occupation.
This iconic image presents Stańczyk as the conscience of a nation, foreseeing doom while others celebrate.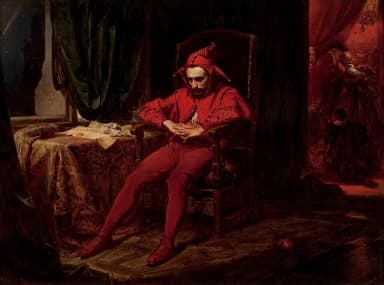
Stańczyk
Jan Matejko
Hämta appen
Museernas problem, och hur vi löste det
Att bli digitalt betydde kostnader, månader av arbete, ingen IT-avdelning och noll data om besökarna. Codigee löste det på ~3 månader.
museo.orchestrate()6 tjänster · 1 hjärna// en backend som hjärna, sex tjänster, i realtid
- Igenkänning på ~100 ms
- Studioröst utan röstskådespelare
- AI alltid redo, ingen kallstart
- Ett sammankopplat ekosystem
- Från koncept till produkt på ~3 månader
Mer information: så funkar det
För de flesta museer har digitalisering alltid inneburit en brutal kompromiss. Ljudguider på hårdvara är dyra att hyra, serva och fylla på, och de finns på en handfull språk utan någon anpassning. Att faktiskt digitalisera en samling är ännu värre: att skriva beskrivningar och spela in speakerröst på alla språk som besökarna kan tänkas prata är månader av arbete för kuratorer och röstskådespelare, något som mindre institutioner varken har folk eller pengar till. Så utländska besökare står framför skyltar de inte kan läsa, och museet har ingen aning om hur folk faktiskt rörde sig genom utställningen.
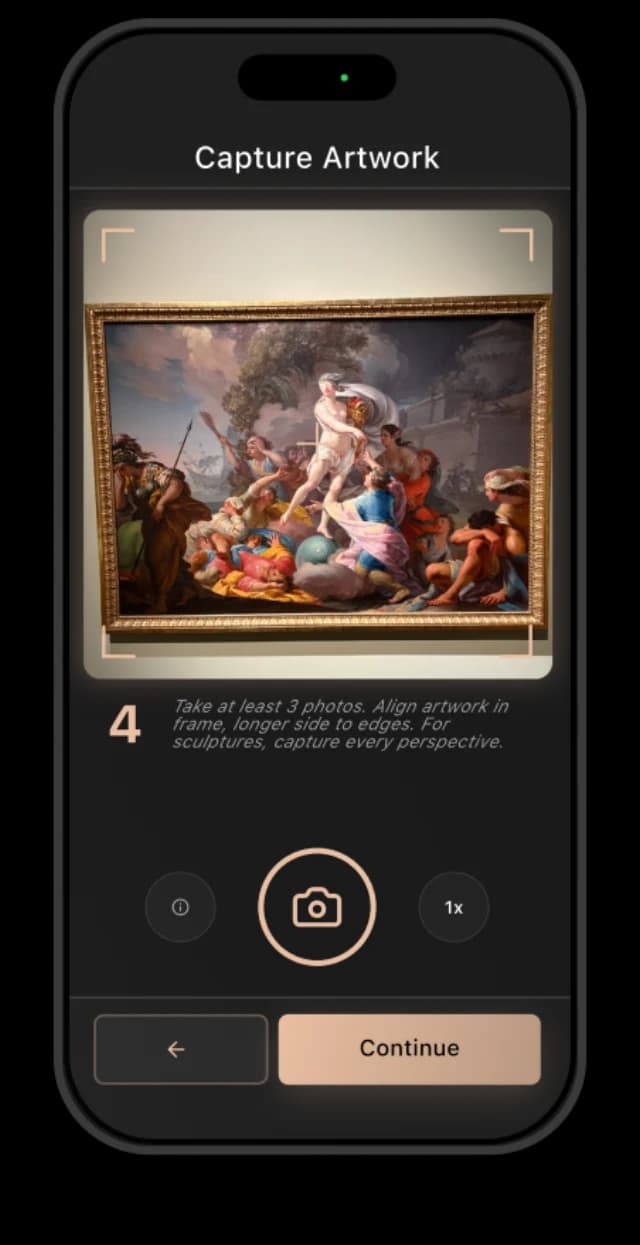
Codigees insikt var att ta bort båda flaskhalsarna på en gång: låt AI göra produktionsarbetet som förr tog månader, och låt varje besökares egen mobil vara guiden i stället för en hyrd apparat. Besökaren fotar vilket konstverk som helst, datorseende känner igen det på ungefär 100 millisekunder och en AI-genererad berättelse spelas upp på besökarens språk. Inga QR-koder, ingen hårdvara, inga inspelningar per språk. För att bevisa hela kedjan innan vi skalade upp lanserade vi Ambassador-appen först, som MVP: verktyget som museets egen personal använder för att fotografera verk och dra igång AI-generering av beskrivningar och berättarröst. Så testade vi hela flödet snabbt mot riktiga föremål.
Det vi levererade är ett sammankopplat ekosystem, inte en enskild app. En besökarapp i Flutter (iOS och Android, gränssnitt på 28 språk) och Ambassador-appen byggs från samma kodbas som två varianter, medan en självbetjänad adminpanel i Next.js låter kuratorer lägga till ett verk, generera beskrivning och berättarröst med ett klick, översätta, publicera och läsa statistik som skanningar, mest visade verk och värmekartor över besöken. Under allt ligger hjärnan: en backend på Bun och Elysia med PostgreSQL, multi-tenant-isolering per museum och Redis/BullMQ-köer som styr AI-arbetet. Hjärnan matar två egna GPU-tjänster som vi byggde från grunden: en snabb modell för igenkänning av konstverk som vi tränade och finjusterade själva, och ett talsyntessystem med tre motorer, verifierat med Whisper. Från koncept till fungerande produkt på ungefär tre månader.
Besökarappen: mobilen är guiden
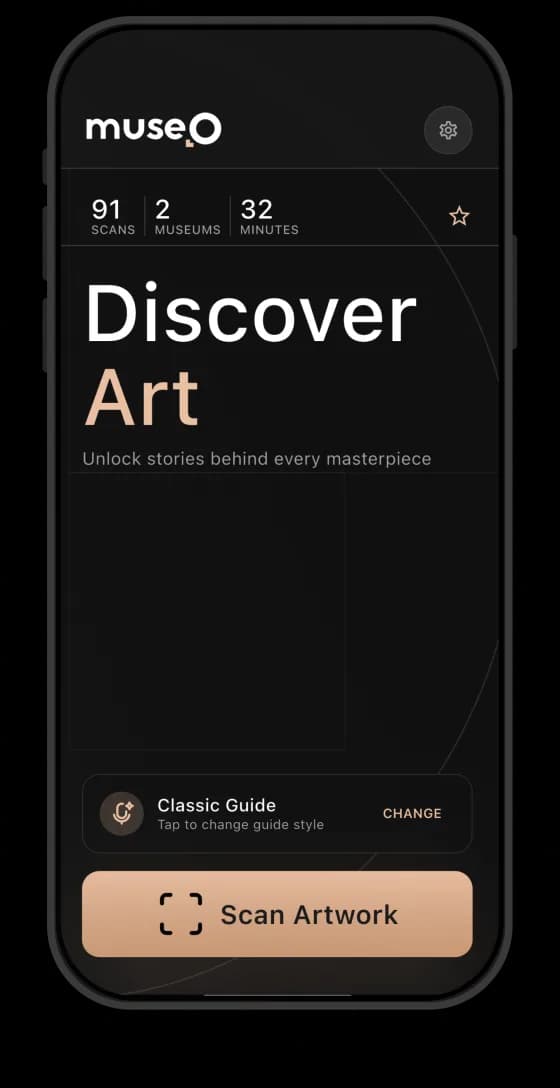
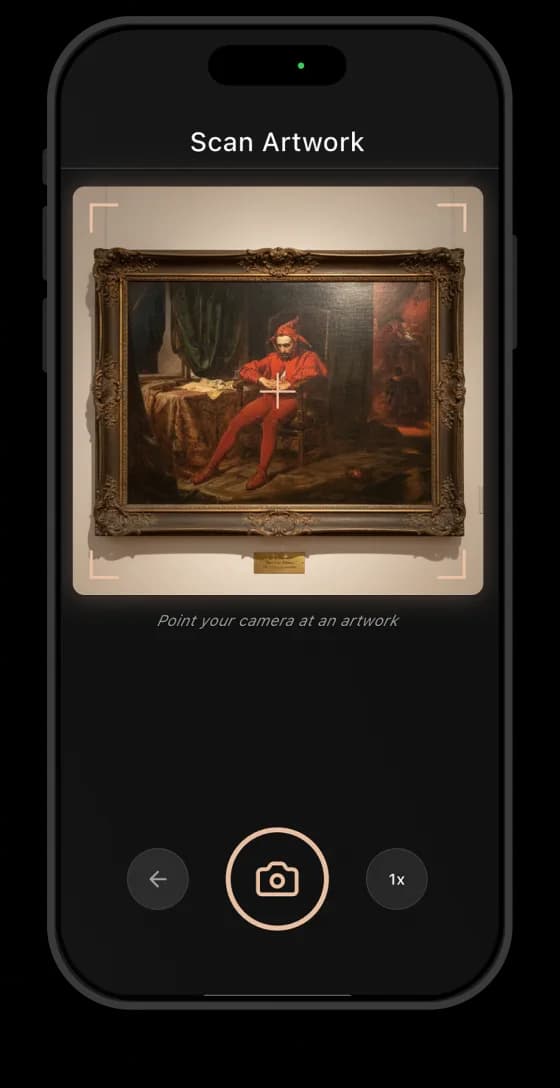
Besökaren fotar ett konstverk och hör en personlig berättelse på sitt eget språk. Det är hela interaktionen.
- Skanna, skriv inte
- Berättelse på ditt språk
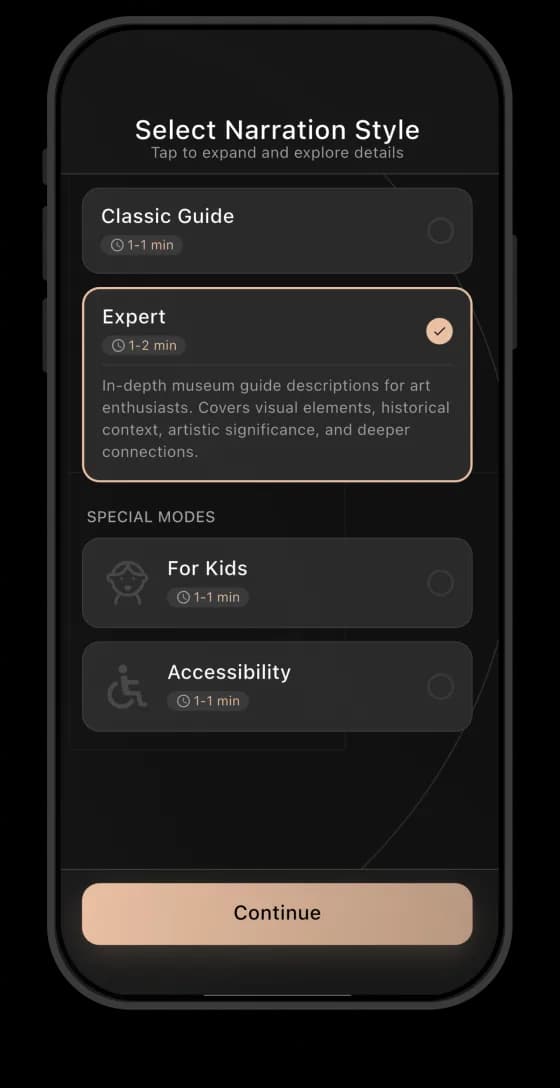
- Röster för alla, även barn
- Ingen hyrd hårdvara
- Inloggning, premium, museer i närheten
Mer information: så funkar det
Upplevelsen är medvetet friktionsfri: rikta kameran mot en målning, en skulptur eller ett föremål så känner appen igen det. Bakom det enda trycket hittar en igenkänningsmodell som vi har tränat och finjusterat konstverket i museets katalog på ungefär 100 millisekunder. Den fungerar snett, i skiftande ljus i salen och bland tusentals föremål, utan QR-koder eller sifferknappar. Berättelsen som spelas upp är AI-genererad, i studiokvalitet och på besökarens språk. För museet försvinner en hel kostnadskategori i det tysta: hyrda apparater, laddställ, service och den handfull språk som apparaterna någonsin klarade.
Språket är huvudfunktionen för utländska besökare som aldrig kunde läsa de lokala skyltarna. Appgränssnittet finns på 28 språk, berättarrösten på 20+, och besökarna väljer en röstprofil som passar dem, bland annat en särskild barnvariant som berättar om samma konstverk för en yngre publik. Hela appen är byggd enligt WCAG 2.1 AA, så den fungerar för besökare som använder skärmläsare, större text och hjälpmedel för navigering.
Inloggningen är ett tryck: Google, Apple eller en engångskod. Därifrån kan besökaren bläddra i hela samlingen, inte bara verket framför sig. Ett B2C-abonnemang (gratis och premium, plus kampanjkoder) gör guiden till en produkt som besökarna tar med sig mellan institutioner, och geolokalisering med PostGIS visar "museer i närheten", så appen fortsätter att fungera i samma stund som de går ut genom en dörr och in i nästa galleri. Resultatet är en guide som följer med besökaren i stället för att lämnas tillbaka vid utgången.
Så skapar ett museum sin ljudguide
Allt du behöver för en komplett ljudguide är en mobil och en inloggning. Inget annat.
Ladda ned Ambassador-appen
Fotografera och lägg till konstverken
Fota varje verk och skylten bredvid, appen sköter resten.
Be Museo köra flödet
Be oss köra flödet för ditt museum, så genererar och kontrollerar vi hela guiden.
Din ljudguide är klar
Live för besökarna, på flera språk.
Adminpanelen: driv museet själv
Ett kontrollcenter som lämnar tillbaka hela innehållsarbetet till museet. Ingen IT-avdelning behövs.
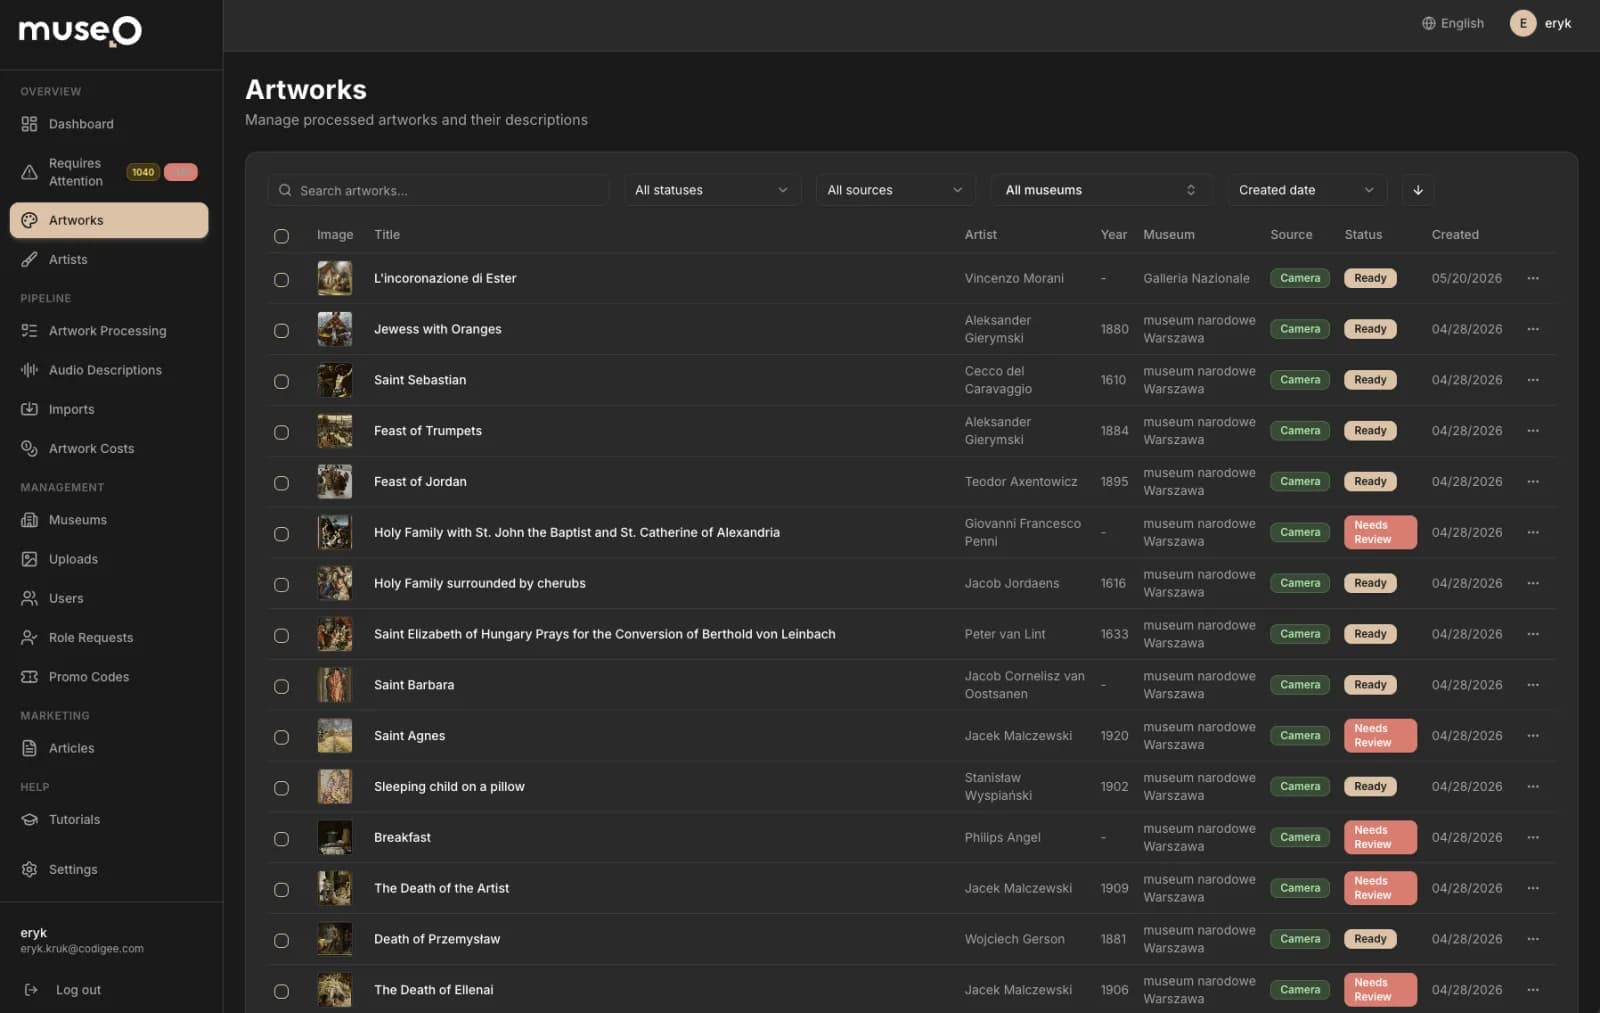
- Innehåll genererat med ett klick
- Kuratorn redigerar och publicerar själv
- Versionshantering fångar inaktuellt innehåll
- Statistik som museer aldrig har haft
- Fullständighet och översättningsmatris
Mer information: så funkar det
Att digitalisera en samling har alltid betytt månader av kuratortexter och inspelningar med röstskådespelare, språk för språk. Det är arbete som de flesta museer inte har folk till, för att inte tala om IT-avdelningen som krävs för att driva programvaran runt omkring. Adminpanelen gör om allt detta till ett självbetjäningsflöde som en enda kurator kan sköta från webbläsaren. Att lägga till ett verk, generera beskrivning och berättarröst, översätta och publicera till varje besökares mobil är bara några klick. Museet har nycklarna: vi byggde panelen just för att de ska kunna driva den utan oss, och själva gränssnittet finns på 20 språk, eftersom de som driver institutionen inte heller alltid pratar engelska.
Varje konstverk börjar med ett foto och ett klick som drar igång hela AI-flödet för innehåll: en LLM skriver ett utkast till beskrivningen, en webbskrapa berikar metadatan, automatisk översättning sprider texten till flera språk och TTS-systemet med tre motorer levererar berättarröst i studiokvalitet. Varje ljudklipp kontrolleras automatiskt av Whisper, som gör om talet till text igen, innan det får publiceras. Kuratorerna har full kontroll: de redigerar text, finjusterar enskilda översättningar och godkänner ljudet i panelen, och publicerar när allt sitter. Ett versionshanteringssystem håller koll på vilka beskrivningar och inspelningar som har blivit inaktuella efter en ändrad prompt och flaggar dem för ny generering. Versionshantering för museiinnehåll, helt enkelt, så att en växande samling aldrig i tysthet blir inaktuell.
För första gången kan museet se hur besökarna faktiskt rör sig genom utställningen. Panelen visar antal skanningar, de mest visade verken och värmekartor över besöken, som avslöjar vilka salar som drar folk och vilka som hoppas över. Den sortens data har ljudguider på hårdvara aldrig samlat in. En översikt över samlingens fullständighet visar exakt vilka verk som fortfarande saknar beskrivning eller ljud, och en översättningsmatris visar täckningen språk för språk, så att luckorna syns direkt i stället för att en förvirrad besökare hittar dem. Under huven håller backendens multi-tenant-isolering varje museums innehåll och statistik strikt åtskilda, så samma självbetjäningspanel skalar från ett enda galleri till en nationell institution.
Tre kärnalgoritmer, en plattform
Igenkänningsmodellen, den verifierade TTS-stacken och backenden som hjärna. Växla mellan de tre motorerna som får Museo att fungera.
museo.recognize(photo)Igenkänning som funkar på alla konstverk
En igenkänningsmodell som vi har tränat hittar vilket konstverk som helst i rätt museum på ~100 ms, även från ett snabbt foto taget snett. Inga QR-koder.
- 01
Besökarens foto
1 tryck · vilken vinkel som helst
- 02
Visionsmodell
→ känner igen verket
- 03
Avgränsad sökning
bara det här museet
- 04resultat
Matchat konstverk
~100 ms
// igenkänning snett och i alla ljus, utan QR-koder
- En modell tränad på samlingen
- Igenkänd på ~100 ms
- Avgränsad per museum, ingen sammanblandning
- Funkar där QR-koder inte gör det
- Direkt, alltid redo
Mer information: så funkar det
Vi löste det på samma sätt som människor faktiskt känner igen saker: genom att förstå vad som finns i bilden, inte genom att läsa av en kod på väggen. Varje konstverk i museets samling lärs in av en visionsmodell som vi har tränat och finjusterat på museets egna verk. När en besökare tar ett foto känner samma modell igen verket direkt. Den svarar på "vilket konstverk är det här?" utifrån själva bilden, så en dålig vinkel, reflexer eller en delvis avskuren bild sabbar inte igenkänningen som de skulle göra med en streckkod eller QR-kod.
Snabbhet är precis vad modellen är finjusterad för: den hittar rätt konstverk på runt 100 ms, strikt avgränsat till det museet, så att två gallerier med liknande verk aldrig blandas ihop. Eftersom den känner igen själva verket och inte en stel kod håller den i verkligheten: en duk fotograferad från sidan, en skulptur under varma spotlights, en ram som är delvis avskuren, en samling på tusentals verk. Samma robusthet som gör den förlåtande för besökarna är det som gör den möjlig att införa: ingen kurator behöver skriva ut, klistra upp och underhålla en lapp på varje vägg.
Den sista utmaningen är att få datorseende i realtid att kännas omedelbart i ett riktigt galleri. Igenkänningsmodellen körs på GPU och hålls redo innan efterfrågan kommer, så den svarar i samma stund som besökaren lyfter mobilen. Ingen fördröjning från kallstart, ingen snurra framför målningen. Resultatet är AI-igenkänning i studiokvalitet som känns omedelbar för besökaren och som körs så effektivt att varje institution, från ett enda galleri till ett nationalmuseum, kan lita på den varje dag.
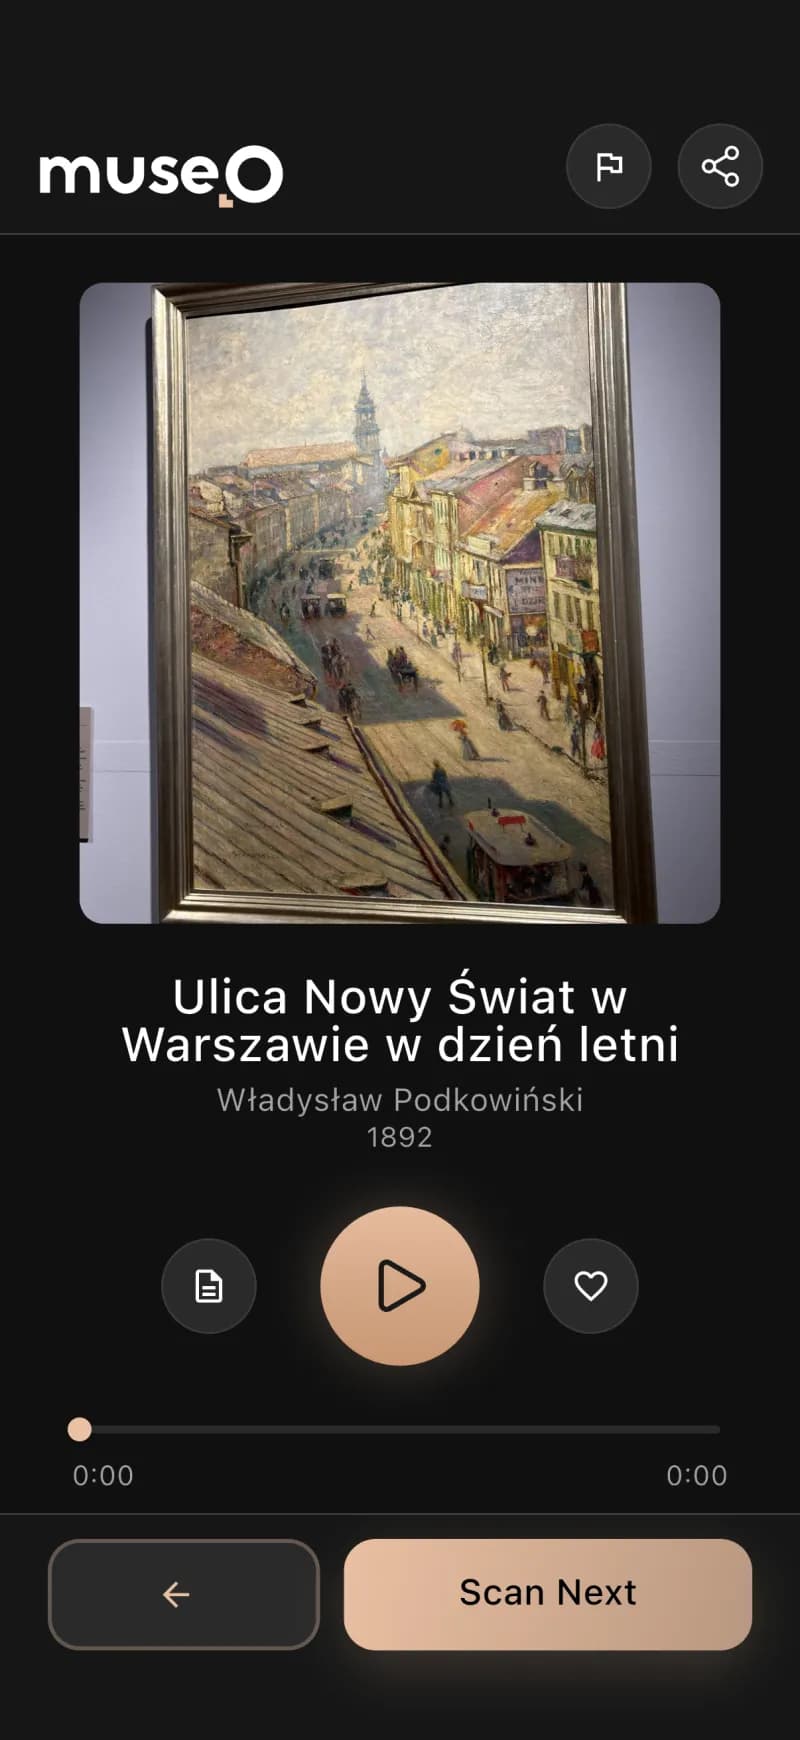
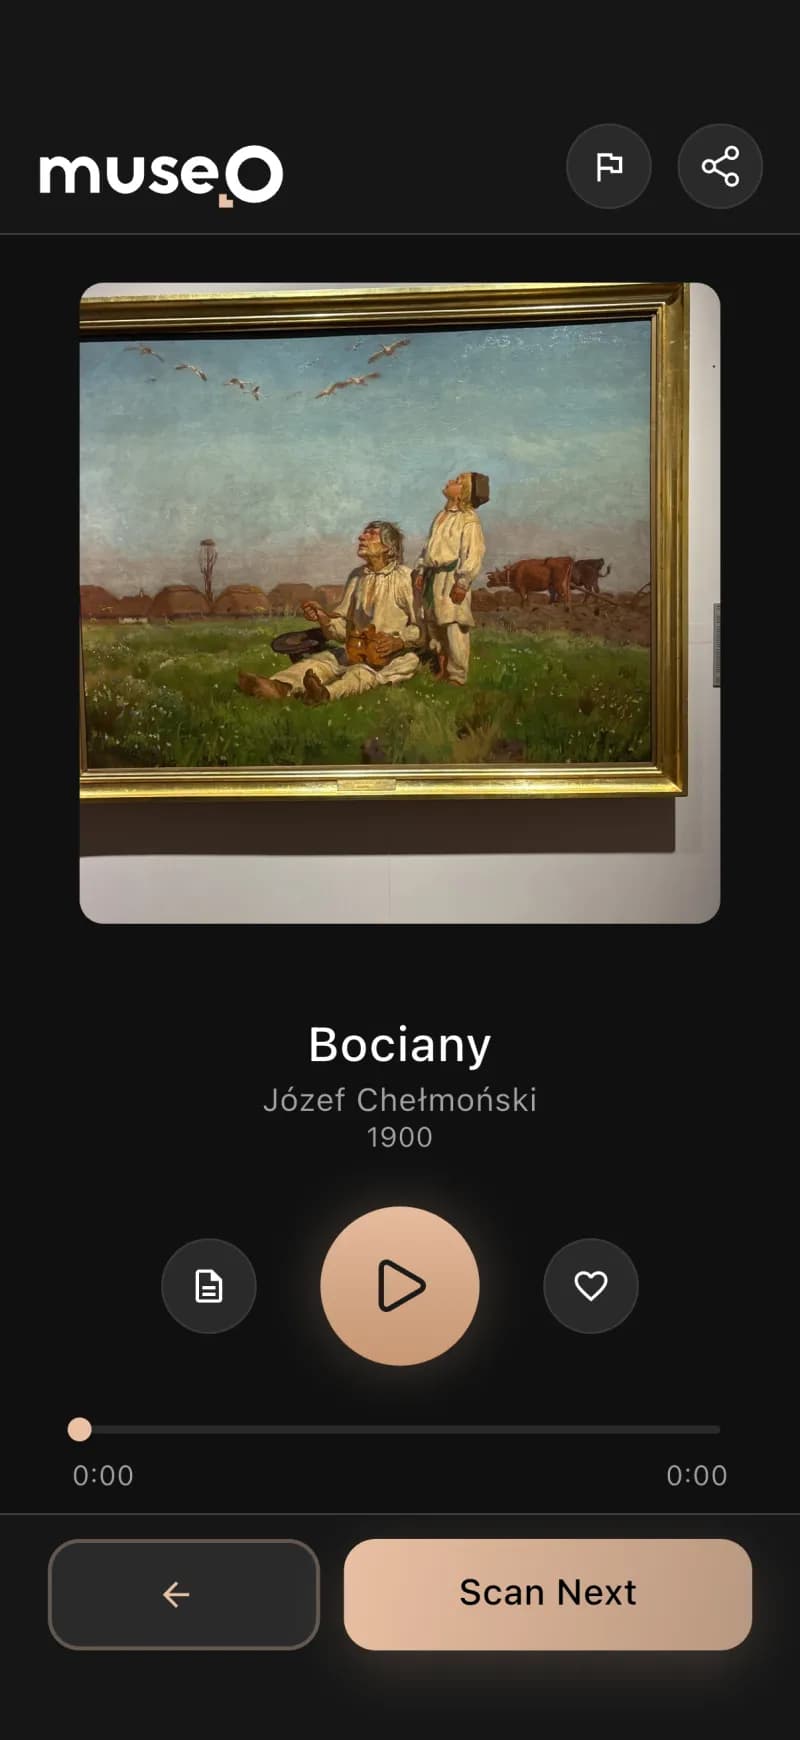
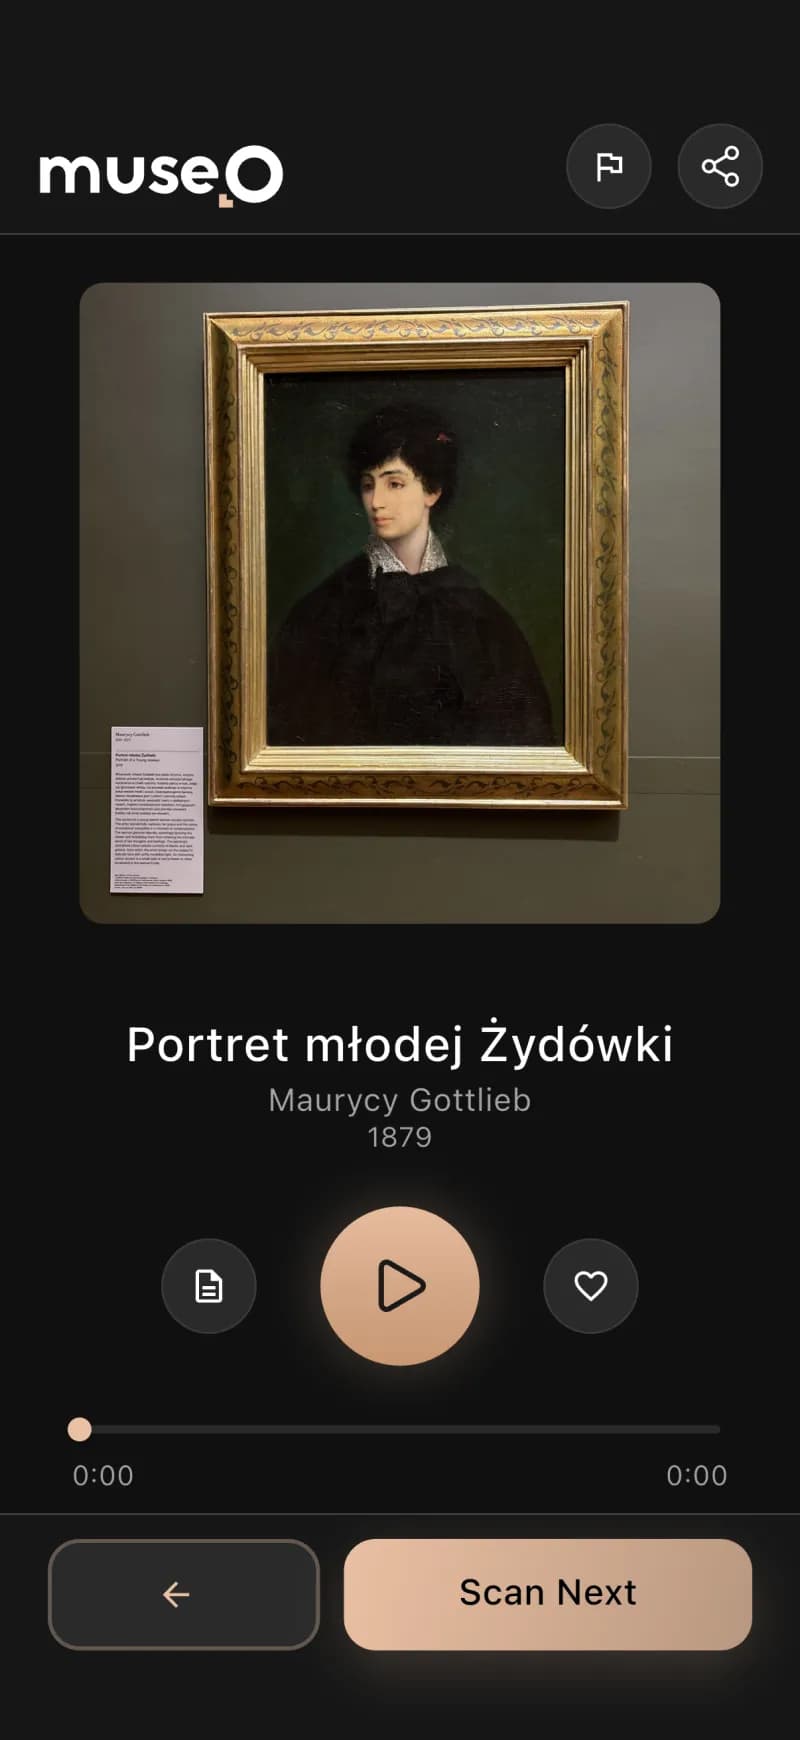
Riktiga konstverk, igenkända på ~100 ms
Det vi levererade
~3 mån
till en fungerande produkt
6
integrerade komponenter
2×2
iOS/Android × Besökare/Ambassador
WCAG 2.1 AA
tillgänglighet
Ljudguide-app för museer: vanliga frågor
Vad är en ljudguide-app för museer?
En ljudguide-app för museer gör besökarens egen smartphone till en personlig guide och ersätter hyrda apparater. Museo är ett AI-ljudguidesystem för museer: besökaren skannar vilket konstverk som helst och en berättelse på besökarens språk spelas upp automatiskt. Så kan museet erbjuda en förstklassig guidad upplevelse utan att köpa eller underhålla någon hårdvara.
Hur fungerar en AI-ljudguide för museer?
Med Museo riktar besökaren mobilkameran mot ett konstverk. AI-baserat datorseende känner igen verket på ungefär 100 millisekunder och spelar upp en AI-genererad berättelse på besökarens språk. Inga QR-koder, inga sifferknappar och ingen hyrd apparat.
Stöder ljudguide-appen flera språk?
Ja. Museo är en flerspråkig museiguide med AI-berättarröst på 20+ språk och ett appgränssnitt på 28, så varje besökare kan följa hela samlingen på sitt eget språk.
Hur lång tid tar det att bygga ett ljudguidesystem för ett museum?
Codigee byggde hela Museo-plattformen (besökarapp, Ambassador-app, adminpanel, backend och AI-tjänster) från koncept till fungerande produkt på ungefär 3 månader, genom att låta AI generera beskrivningar, översättningar och berättarröst i stället för månader av manuellt arbete för kuratorer och röstskådespelare.
Vad kostar det att driva en AI-ljudguide på ett museum?
Museo ersätter dyr, hyrd ljudguidehårdvara med programvara som körs på varje besökares egen mobil. Inga apparater att köpa, ladda, serva eller fylla på. AI:n är byggd för att köras effektivt, så även ett litet museum kan utan problem driva ett komplett, flerspråkigt AI-ljudguidesystem.
Har du en AI-produkt i tankarna? Vi bygger den.
Let's make something together.
Inget överkrångel. Ingen bortkastad tid. Bara rakt på sak och leverans.
 Eller boka ett samtal med Eryk (öppnar bokningskalendern)[email protected]